IP-Adapter는 무엇인가 — 그림을 프롬프트로 넣는 작은 어댑터
IP-Adapter는 Tencent AI Lab 연구진이 2023년 8월 13일 arXiv에 올린 논문에서 나왔다. 논문의 출발점은 단순하다. 글 프롬프트만으로 원하는 그림을 얻으려면 복잡한 프롬프트 다듬기가 필요하고, 그 대안으로 «그림 한 장이 천 마디 말»이라는 이미지 프롬프트를 쓰자는 것이다. 이전에도 기존 모델을 그림 임베딩으로 통째 미세조정하는 방법이 있었지만, 계산 비용이 크고 다른 기반 모델이나 글 프롬프트, 구조 제어 도구와 함께 쓰기 어려웠다고 논문은 짚는다.
IP-Adapter의 답은 원래 모델을 건드리지 않고 옆에 작은 길을 하나 더 내는 것이다. 논문은 이 어댑터의 핵심을 «분리된 교차 주의(decoupled cross-attention)»라고 부르고, 파라미터 22M짜리 어댑터가 전체를 미세조정한 이미지 프롬프트 모델과 비슷하거나 더 나은 성능을 낸다고 적었다. 기본 모델을 얼려 둔 채 붙이기 때문에 같은 기반에서 미세조정한 커뮤니티 모델에도, 기존 제어 도구에도 그대로 쓸 수 있다는 점도 함께 내세웠다.
글 길과 그림 길을 따로 두는 구조
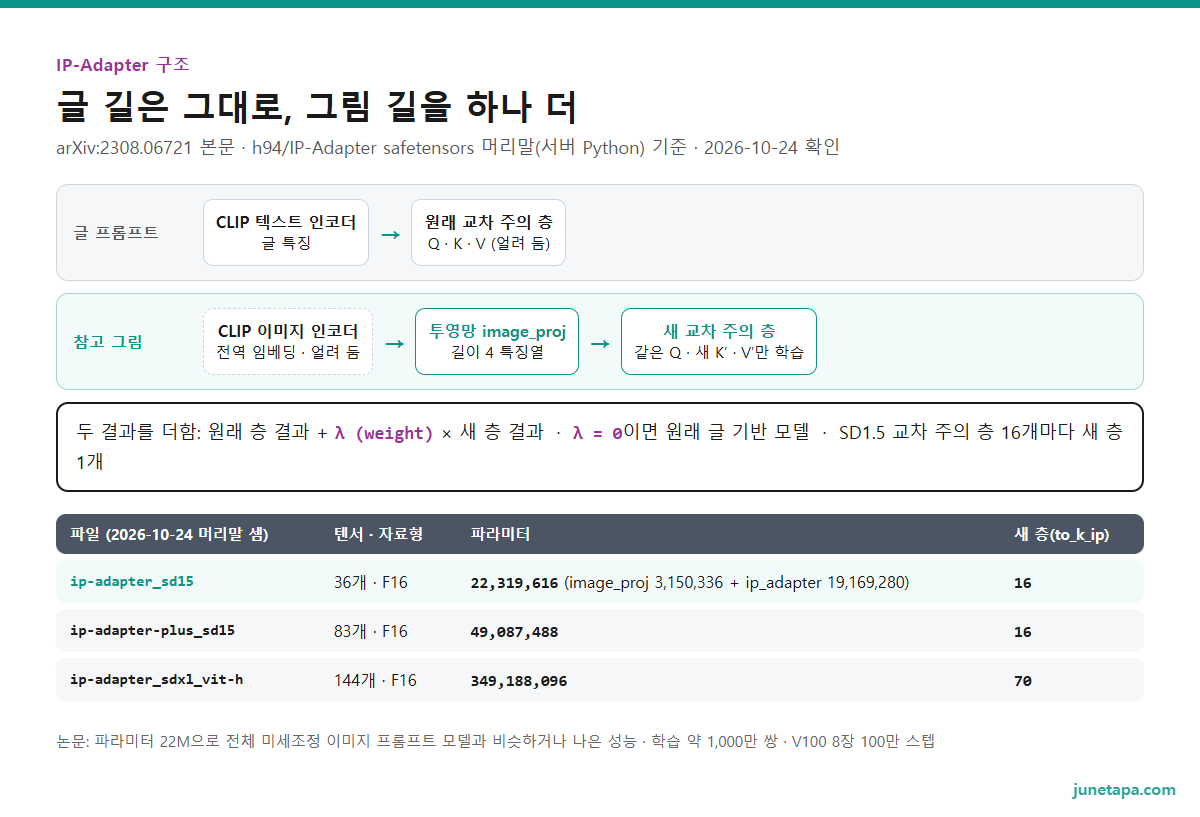
논문 본문을 따라가면 길은 이렇게 생겼다. 참고 그림은 먼저 CLIP 이미지 인코더를 지나며, 논문은 이 인코더의 전역 임베딩이 그림의 풍부한 내용과 화풍을 담는다고 설명한다. 학습 때 이 인코더는 얼려 두고, 작은 투영망이 전역 임베딩을 길이 4의 특징열로 바꿔 글 특징과 같은 차원으로 맞춘다. 그다음이 핵심이다. 스테이블 디퓨전 1.5의 UNet에는 교차 주의 층이 16개 있고, IP-Adapter는 그 층마다 그림 특징만 보는 새 교차 주의 층을 하나씩 붙인다. 새 층은 글 쪽과 같은 query를 쓰므로 층마다 key와 value 가중치 두 개만 새로 배우면 된다. 두 층의 결과는 더해지고, 그림 쪽 결과에는 가중치 λ가 곱해지며, 논문은 λ가 0이면 원래의 글 기반 모델로 돌아간다고 적었다. ComfyUI 노드의 weight 칸이 바로 이 세기를 다루는 손잡이다.
논문의 22M이 정말 파일에 들어 있는지 궁금해, 2026년 10월 24일 서버의 Python 3.14.8로 Hugging Face의 h94/IP-Adapter 저장소에 있는 safetensors 파일의 머리말만 받아 텐서를 셈해 보았다. SD1.5 기본 파일 ip-adapter_sd15.safetensors는 텐서 36개가 모두 F16이었고, 파라미터는 22,319,616개였다. 투영망 쪽(image_proj)이 3,150,336개, 새 교차 주의 쪽(ip_adapter)이 19,169,280개이며, 새 key 가중치(to_k_ip)를 단 층은 16개로 논문의 층 수와 맞았다. 더 세게 옮기는 PLUS판 ip-adapter-plus_sd15.safetensors는 텐서 83개, 파라미터 49,087,488개였는데, 새 교차 주의 쪽은 기본판과 같은 19,169,280개이고 투영망 쪽만 29,918,208개로 커졌다. 확장 소스 코드도 PLUS 계열은 참고 그림을 16개 토큰으로, 기본판은 4개 토큰으로 넘기도록 나눠 두었다. 같은 방법으로 본 SDXL용 ip-adapter_sdxl_vit-h.safetensors는 새 층이 70개, 파라미터가 349,188,096개로, SD1.5판보다 열다섯 배 남짓 크다. 학습 규모도 논문에 적혀 있는데, 약 1,000만 쌍의 글 · 그림 데이터로 V100 8장에서 100만 스텝을 돌렸다.
IP-Adapter와 LoRA · ControlNet 차이 — 무엇을 옮기는가
ComfyUI 쪽 확장을 만든 cubiq는 README 첫머리에서 IP-Adapter를 «1장짜리 LoRA로 생각하라»고 소개한다. 참고 그림의 대상이나 화풍만을 생성 결과로 쉽게 옮긴다는 설명이 붙어 있다. 비유가 꽤 정확하다. LoRA는 여러 장의 그림으로 미리 학습한 패치 파일을 체크포인트 위에 덧대는 방식이라, 학습한 인물이나 화풍을 꾸준히 불러낸다. 노드 연결과 강도 두 칸은 LoRA 적용 편에 정리했다. IP-Adapter는 학습 없이 그림 한 장을 그 자리에서 읽는다. 대신 그 그림에서 무엇을 가져갈지는 모델이 CLIP 임베딩으로 읽어 낸 범위로 정해진다.
ControlNet과는 옮기는 대상이 다르다. ControlNet은 포즈 뼈대나 윤곽선 같은 밑그림을 따라 구도와 자세를 고정한다. 노드 넷과 강도 · 시작 · 종료 세 칸은 ControlNet 편에 있다. IP-Adapter가 옮기는 것은 색감, 재질, 분위기, 그리고 대략의 내용이다. 그래서 둘은 겹치지 않고 함께 쓰인다. 논문은 IP-Adapter가 기존의 제어 도구와 함께 쓸 수 있다고 밝혔고, Tencent 저장소도 ControlNet과 T2I-Adapter를 곁들인 «구조 생성» 예제를 따로 올려 두었다. 구도는 ControlNet으로, 느낌은 IP-Adapter로 나눠 맡기는 조합이다.
같은 얼굴을 그대로 옮기지는 못한다
IP-Adapter의 한계는 논문이 스스로 적어 두었다. 논문 결론부는 IP-Adapter가 참고 그림과 내용 · 화풍이 닮은 그림을 만드는 데까지이고, Textual Inversion이나 DreamBooth처럼 주어진 대상과 높은 일관성을 지키는 그림은 만들지 못한다고 밝혔다. 확장 README도 얼굴 전용 FaceID 모델을 따로 두는데, 이 모델들은 insightface를 ComfyUI 환경에 따로 설치해야 하고 대부분 짝이 되는 LoRA까지 함께 받아야 한다. 한 캐릭터를 여러 장에 걸쳐 같은 얼굴로 그리고 싶다면 IP-Adapter 하나보다 LoRA 학습이나 캐릭터 시트 방법을 먼저 보는 편이 맞다는 것이 글쓴이의 정리다. 이 글이 실존 인물 사진을 예로 들지 않는 것도 같은 이유다. 남의 얼굴 사진을 참고 그림으로 넣는 일은 결과의 닮음과 상관없이 초상권 문제를 따로 따져야 한다.
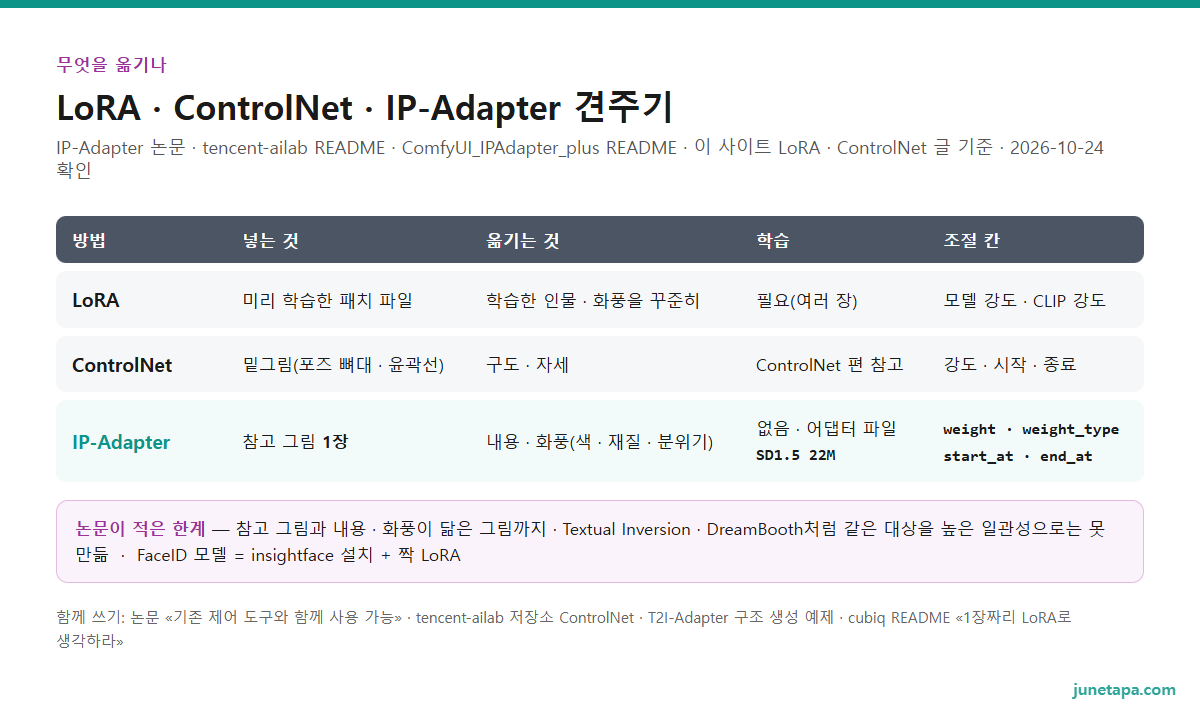
인용 — Hu Ye 외. IP-Adapter 논문 (arXiv:2308.06721)«Despite the effectiveness of our IP-Adapter, it can only generate images that resemble the reference images in content and style.» — IP-Adapter가 효과적이긴 하지만, 참고 그림과 내용 · 화풍이 닮은 그림을 만들 수 있을 뿐이다.
모델을 만든 연구진이 직접 적은 한계다. 느낌을 옮기는 도구로 쓰고, 같은 대상을 똑같이 되살리는 일은 다른 방법에 맡기라는 뜻으로 읽힌다.
ComfyUI IP-Adapter 설치 — IPAdapter plus 확장과 파일 이름
ComfyUI 본체에는 IP-Adapter 노드가 들어 있지 않아 확장을 깐다. Tencent 저장소가 2023년 9월 5일 ComfyUI 지원을 알리며 이름을 든 확장 가운데 하나가 cubiq의 ComfyUI_IPAdapter_plus다. 설치는 이 저장소를 ComfyUI/custom_nodes 폴더에 받거나 ComfyUI Manager로 한다.
먼저 알아 둘 상태가 있다. README 맨 위에는 2025년 4월 14일자로 «저장소를 maintenance only(유지보수 전용) 모드로 둔다»는 공지가 붙어 있다. 중요한 수정이나 풀 리퀘스트는 받아들일 수도 있지만 꾸준한 작업은 계획하지 않는다는 내용이다. 2026년 10월 24일 GitHub API로 본 커밋 기록도 같은 날의 «maintenance mode» · «wording» 두 커밋이 마지막이었다. 그런데 같은 README의 설치 절은 «IPAdapter는 언제나 최신 ComfyUI를 요구한다»고 적고 있다. 확장은 멈췄는데 본체는 계속 바뀌는 셈이다. 그래서 IP-Adapter 워크플로를 쓰는 PC라면 ComfyUI를 올리기 전에 지금 상태를 되돌릴 길부터 마련해 두는 편이 낫다는 것이 글쓴이의 판단이다. 되돌리는 법은 업데이트 뒤 안 켜질 때 편에 있다.
파일 두 종류와 프리셋 여섯
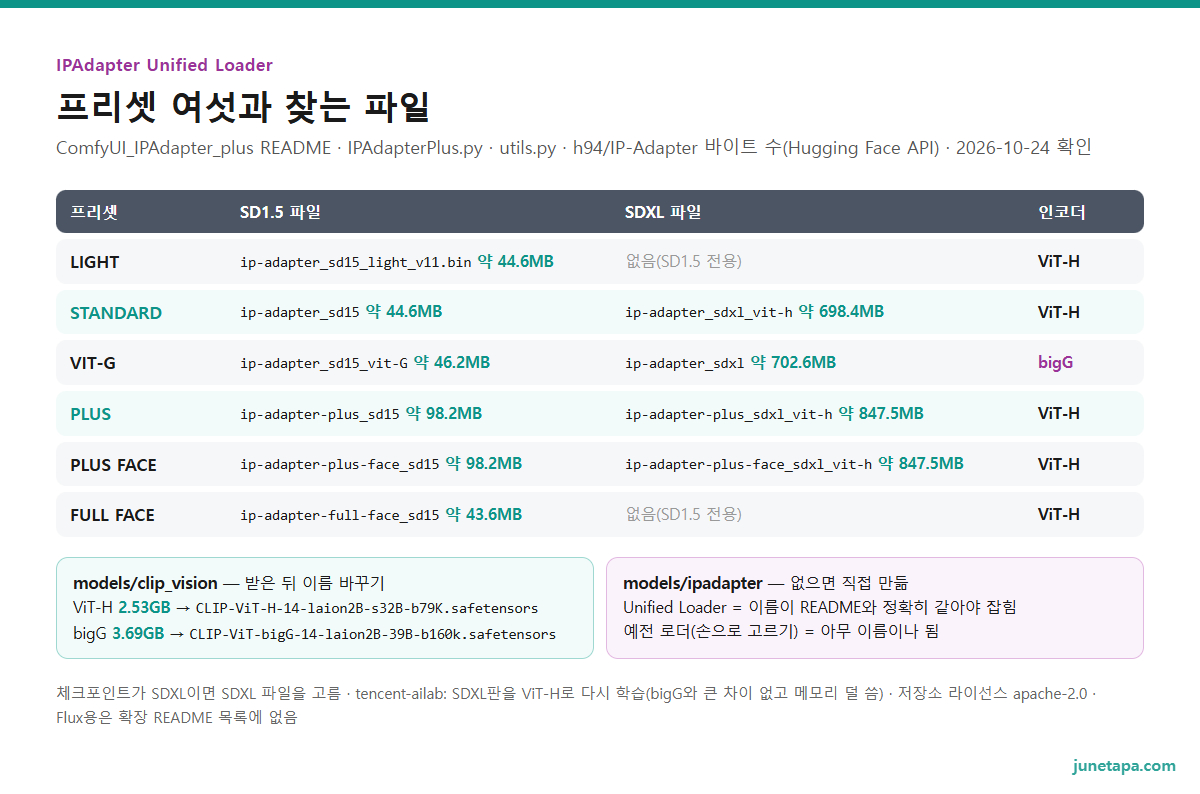
필요한 파일은 두 종류다. 그림을 읽는 CLIP 이미지 인코더는 models/clip_vision 폴더에, 어댑터 파일은 직접 만들어야 하는 models/ipadapter 폴더에 둔다. 함정은 이름이다. README는 인코더를 Hugging Face h94 저장소에서 model.safetensors라는 이름으로 받은 뒤 CLIP-ViT-H-14-laion2B-s32B-b79K.safetensors처럼 정해진 이름으로 바꾸라고 적었고, 새로 생긴 Unified Loader가 작동하려면 파일 이름이 목록과 정확히 같아야 한다고 못 박았다. 이름을 손으로 고르는 예전 로더들은 아무 이름이나 받는다. 소스 코드를 보면 Unified Loader는 프리셋마다 파일 이름 패턴을 정해 두고 그 패턴으로 폴더를 찾는다.
2026년 10월 24일 Hugging Face API로 본 h94 저장소의 크기는 이렇다. ViT-H 인코더는 2,528,373,448바이트(약 2.53GB), bigG 인코더는 3,689,912,664바이트(약 3.69GB)다. 어댑터 파일은 훨씬 작아서, SD1.5 기본 ip-adapter_sd15.safetensors가 44,642,768바이트(약 44.6MB), SD1.5 PLUS가 약 98.2MB, SDXL 기본 ip-adapter_sdxl_vit-h.safetensors가 약 698.4MB, SDXL PLUS가 약 847.5MB다. 저장소 라이선스 표기는 apache-2.0이고 로그인 동의 절차는 없다.
IPAdapter Unified Loader의 프리셋은 여섯 개다. LIGHT(SD1.5 전용 · 약하게), STANDARD(보통), VIT-G(보통), PLUS(강하게), PLUS FACE(인물 얼굴), FULL FACE(SD1.5 전용 · 얼굴 더 강하게)다. 연결한 체크포인트가 SDXL인지 보고 SD1.5용과 SDXL용 가운데 맞는 파일을 고르며, 인코더는 VIT-G 프리셋만 bigG를 찾고 나머지는 모두 ViT-H를 찾는다. SDXL 체크포인트에 LIGHT나 FULL FACE를 고르면 «light model is not supported for SDXL»처럼 지원하지 않는다는 오류로 멈춘다. 나머지 파일 크기도 적어 두면, LIGHT의 ip-adapter_sd15_light_v11.bin이 약 44.6MB, VIT-G용은 SD1.5판 약 46.2MB · SDXL판 ip-adapter_sdxl 약 702.6MB, FULL FACE가 약 43.6MB이고, PLUS FACE는 SD1.5 · SDXL 모두 PLUS와 같은 약 98.2MB · 847.5MB다. Tencent 저장소는 2023년 9월 8일 SDXL판을 ViT-H 인코더로 다시 학습하면서, bigG가 훨씬 크지만 실험에서 큰 차이를 찾지 못했고 작은 인코더가 추론 메모리를 줄인다고 적었다. 그래서 처음이라면 ViT-H 인코더 하나와 STANDARD · PLUS 파일로 시작하면 된다. SD1.5와 SDXL 가운데 어느 쪽을 먼저 쓸지는 SD1.5 · SDXL · Flux 고르기 편을 참고하면 된다. 확장 README의 모델 목록은 SD1.5 · SDXL과 커뮤니티 Kolors 모델까지이고 Flux용은 없다. Flux에서 참고 그림을 써서 그림을 고치는 길은 Flux Kontext 편에 따로 정리했다.
IP-Adapter 노드 잇기와 weight · 224 자르기
연결은 짧다. 확장의 예제 ipadapter_simple.json을 서버의 Python으로 풀어 보니, Load Checkpoint의 MODEL이 IPAdapter Unified Loader를 지나고, 로더의 MODEL과 IPADAPTER 두 출력이 IPAdapter 노드로 들어간 뒤, IPAdapter 노드의 MODEL이 KSampler로 간다. 참고 그림은 Load Image에서 IPAdapter 노드의 image 칸으로 들어간다. 프롬프트 · 빈 잠재 · VAE Decode 쪽은 평소 글로 그리는 워크플로와 같다. 이 예제는 PLUS 프리셋에 weight 0.8을 쓰고, KSampler는 30스텝 · cfg 6.5 · dpmpp_2m · karras, 빈 잠재는 512×512로 두었다.
IPAdapter 노드의 칸은 weight · start_at · end_at · weight_type 넷이다. 소스 코드의 기본값은 weight 1.0, start_at 0, end_at 1이다. start_at과 end_at은 ControlNet의 시작 · 종료 퍼센트처럼 샘플링의 어느 구간에서 어댑터를 켤지 정한다. README는 weight를 적어도 0.8까지 낮추고 스텝 수를 늘려 보라고 권하고, 프롬프트를 더 따르게 하려면 IPAdapter Advanced 노드에서 weight type을 바꿔 보라고 적었다. Tencent 저장소의 권장도 비슷한 방향이다. 그림만으로 그릴 때는 scale 1.0에 프롬프트를 비우고, 글과 섞을 때는 대개 0.5에서 좋은 결과가 난다고 했다. diffusers 문서도 1.0을 최대 세기, 0.5를 글과 그림이 대개 균형을 이루는 값으로 소개한다.
weight type은 어느 층에 넣을지를 고른다
기본 IPAdapter 노드의 weight_type은 standard, prompt is more important, style transfer 셋뿐인데, 소스 코드를 보면 이 셋은 안에서 각각 linear, ease out, style transfer로 바뀐다. IPAdapter Advanced 노드에서는 linear부터 composition precise까지 15가지를 고를 수 있다. 이 가운데 style transfer와 composition은 세기를 바꾸는 것이 아니라 넣을 층을 고른다. SDXL 모델일 때 style transfer는 6번 블록 한 곳에만, composition은 3번 블록 한 곳에만 weight를 준다. SD1.5일 때 style transfer는 16개 층 가운데 11곳에 weight를 준다. 확장 README의 감사 목록에는 InstantStyle이 들어 있는데, InstantStyle은 SDXL의 특정 주의 층 두 곳 가운데 한 곳이 색 · 재질 · 분위기 같은 화풍을, 다른 한 곳이 구조 · 구도 같은 공간 배치를 맡는다는 관찰을 내놓았다. 화풍만 가져오고 참고 그림 속 물건은 따라오지 않게 하고 싶을 때 style transfer를 먼저 고르는 이유다.
참고 그림은 가운데 224×224만 읽힌다
마지막 함정은 참고 그림의 모양이다. 확장 소스는 CLIP 인코더에 넣을 크기를 224로 두고, 참고 그림이 정사각형이 아니면 «CLIPImageProcessor가 크기를 바꾸고 가운데를 자른다 · 주제가 가운데에 있지 않으면 기대와 다른 결과가 나올 수 있다»는 안내를 명령 창에 띄운다. ComfyUI 본체의 clip_preprocess 함수도 짧은 변을 224에 맞춘 뒤 가운데 224×224를 잘라 낸다. Tencent 저장소 역시 CLIP 기본 처리기가 가운데를 자르므로 IP-Adapter는 정사각형 그림에서 가장 잘 맞고, 정사각형이 아니면 가운데 밖의 정보를 놓친다고 적었다.
얼마나 잘리는지 보려고 2026년 10월 24일 서버의 Python으로 clip_preprocess의 식을 그대로 옮겨 돌려 보았다. 1920×1080 가로 그림은 398×224로 줄어든 뒤 좌우가 87px씩 잘려 넓이의 56.3%만 남았다. 세로 1080×1920도 위아래가 똑같이 잘려 56.3%였다. 세로 832×1216 그림은 224×327로 줄어 위아래 51 · 52px이 잘리며 68.5%, 768×1024는 224×299에서 위아래 37 · 38px이 잘려 74.9%, 3:2 비율의 3000×2000은 336×224에서 좌우 56px씩 잘려 66.7%가 남았다. 1024×1024 같은 정사각형만 잘리는 곳 없이 100%가 들어갔다. 가로로 긴 풍경을 참고 그림으로 넣으면 양 끝의 하늘이나 소품이 거의 반쯤 빠진 채 읽힌다는 뜻이다.
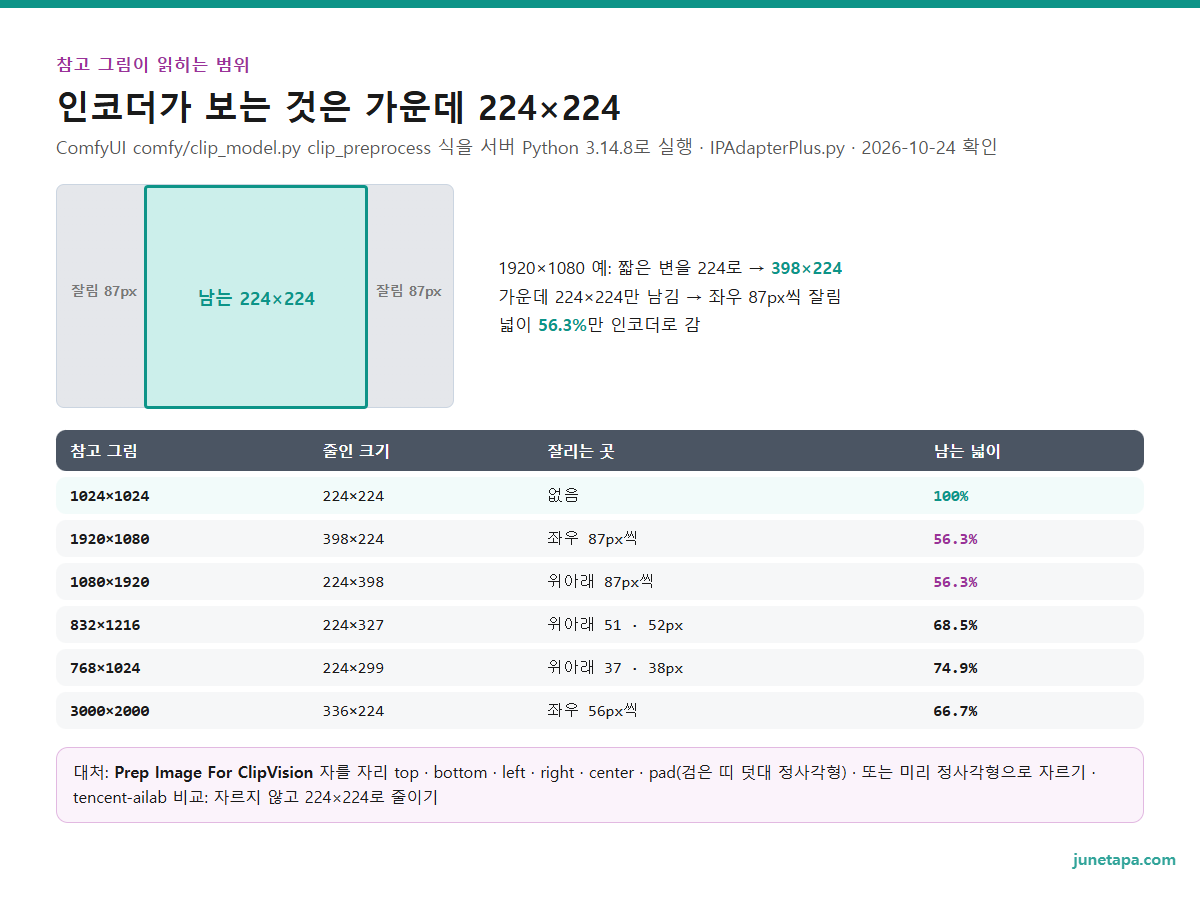
해결 길은 두 가지다. 확장에 들어 있는 Prep Image For ClipVision 노드는 자를 자리를 top · bottom · left · right · center 가운데서 고르거나, pad로 잘라 내지 않고 짧은 쪽 양옆에 검은 띠를 덧대 정사각형을 만든 뒤 224×224로 줄인다. Tencent 저장소는 정사각형이 아닌 그림을 자르지 않고 그냥 224×224로 줄여 넣는 방법도 비교해 보여 준다. 주제가 한쪽에 치우친 그림이라면 미리 정사각형으로 잘라 두거나 이 노드로 자를 자리를 고르는 편이, 무엇이 읽힐지를 직접 정할 수 있어 낫다는 것이 이 계산에서 얻은 결론이다. 워크플로를 불러왔는데 IP-Adapter 노드가 빨갛게 비어 있다면 확장이 설치됐는지부터 보고, 오류 문구별 점검은 ComfyUI 오류 메시지 편을 함께 보면 된다.
자주 묻는 것
IP-Adapter는 ComfyUI에 기본으로 들어 있나요?
들어 있지 않습니다. ComfyUI_IPAdapter_plus 같은 확장을 custom_nodes 폴더에 설치하거나 ComfyUI Manager로 받아야 합니다. 이 확장은 2025년 4월 14일부터 유지보수 전용 모드라 새 기능 작업이 계획돼 있지 않고, README는 늘 최신 ComfyUI를 요구한다고 적고 있으므로 본체를 올리기 전에 되돌릴 길을 마련해 두는 편이 안전합니다.
모델을 넣었는데 Unified Loader가 파일을 못 찾아요.
대개 파일 이름 문제입니다. Unified Loader는 프리셋마다 정해진 이름 패턴으로 파일을 찾기 때문에, Hugging Face에서 model.safetensors로 받은 인코더는 CLIP-ViT-H-14-laion2B-s32B-b79K.safetensors처럼 README의 이름으로 바꿔 clip_vision 폴더에 두어야 합니다. 어댑터 파일은 직접 만든 ipadapter 폴더에 넣습니다. 이름을 바꾸기 어렵다면 파일을 손으로 고르는 IPAdapter Model Loader 같은 예전 로더를 쓰면 됩니다.
weight는 얼마로 시작하면 되나요?
확장 README는 weight를 적어도 0.8까지 낮추고 스텝을 늘려 보라고 권하고, 확장의 예제 워크플로도 0.8을 씁니다. 글 프롬프트와 섞어 쓸 때는 Tencent 저장소와 diffusers 문서가 0.5 언저리를 균형점으로 듭니다. 참고 그림의 물건까지 따라와 곤란하다면 weight를 내리기 전에 weight type을 style transfer로 바꿔 보는 것도 방법입니다.
참고 그림 속 인물과 똑같은 얼굴로 그릴 수 있나요?
논문은 IP-Adapter가 내용과 화풍이 닮은 그림까지만 만들고, DreamBooth처럼 같은 대상을 높은 일관성으로 만들지는 못한다고 밝혔습니다. 얼굴 전용 FaceID 모델은 insightface 설치와 짝 LoRA가 따로 필요합니다. 같은 캐릭터를 여러 장에 걸쳐 그리려면 LoRA 학습이나 캐릭터 시트 방법을 먼저 보는 편이 맞고, 남의 얼굴 사진을 참고 그림으로 쓰는 일은 초상권을 따로 따져야 합니다.
Flux 모델에서도 이 확장을 쓸 수 있나요?
ComfyUI_IPAdapter_plus README의 모델 목록은 SD1.5와 SDXL, 커뮤니티 Kolors 모델까지이고 Flux용은 들어 있지 않습니다. Flux에서 참고 그림을 써서 그림을 고치고 싶다면 입력 그림을 조건 쪽에 싣는 Flux Kontext 같은 편집 모델이 따로 있습니다.
정리 — IP-Adapter를 쓰기 전에 볼 네 가지
IP-Adapter는 참고 그림을 CLIP 이미지 인코더로 읽어, 글과 따로 둔 교차 주의 층에 넣는 작은 어댑터다. SD1.5 기본 파일의 파라미터는 22,319,616개로 논문의 22M과 맞았고, 원래 모델은 얼려 둔 채라 커뮤니티 체크포인트나 ControlNet과 함께 쓸 수 있다. 옮기는 것은 내용과 화풍, 그러니까 그림의 느낌이고, 같은 얼굴을 그대로 되살리는 일은 논문 스스로 한계로 적었다.
시작 전에 볼 것은 네 가지다. 첫째, ComfyUI에서는 확장 ComfyUI_IPAdapter_plus로 쓰며 이 확장은 2025년 4월 14일부터 유지보수 전용이니 본체 업데이트 전에 되돌릴 길을 마련한다. 둘째, 인코더는 clip_vision에, 어댑터는 ipadapter 폴더에 두고 Unified Loader를 쓰려면 이름을 README대로 바꾼다. 셋째, weight는 0.8 언저리에서 시작해 글과 섞을 땐 더 내리고, 화풍만 원하면 weight type을 style transfer로 고른다. 넷째, 참고 그림은 가운데 224×224만 읽히므로 가로로 긴 그림은 미리 정사각형으로 자르거나 Prep Image For ClipVision으로 자를 자리를 정한다.
참고 자료
- Hu Ye 외(Tencent AI Lab). IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion Models (arXiv:2308.06721) — 2023-08-13 제출, 분리된 교차 주의(decoupled cross-attention)로 글 특징과 그림 특징의 교차 주의 층을 나눔, 파라미터 22M으로 전체 미세조정 모델과 비슷하거나 나은 성능, 기본 모델을 얼려 같은 기반의 커뮤니티 모델 · 기존 제어 도구와 함께 쓸 수 있음(2026-10-24 확인). arxiv.org
- Hu Ye 외. IP-Adapter 논문 본문(HTML판) — CLIP 이미지 인코더의 전역 임베딩 사용과 인코더 동결, 투영망으로 길이 4의 특징열, 같은 query에 새 key · value 가중치 둘만 더함, SD의 교차 주의 층 16개마다 새 층, 약 1,000만 쌍(LAION-2B · COYO-700M) · V100 8장 100만 스텝, 가중치 λ가 0이면 원래 모델, 한계(내용과 화풍이 닮은 그림까지 · Textual Inversion · DreamBooth처럼 같은 대상을 높은 일관성으로 만들지는 못함)(2026-10-24 확인). arxiv.org
- tencent-ailab. IP-Adapter GitHub 저장소 README — 2023-08-16 코드 · 모델 공개, 2023-09-05 WebUI · ComfyUI 지원, 2023-09-08 SDXL판을 OpenCLIP ViT-H로 다시 학습(ViT-bigG와 큰 차이 없고 메모리 덜 씀), 그림만 쓸 때 scale 1.0 · 글과 섞을 때 대개 0.5, CLIP 기본 처리기가 가운데를 잘라 정사각형 그림에 가장 잘 맞음 · 224×224로 줄이는 방법(2026-10-24 main 확인). github.com
- cubiq. ComfyUI_IPAdapter_plus README — «1장짜리 LoRA로 생각하라», 2025-04-14 «maintenance only» 공지, custom_nodes 설치 · 최신 ComfyUI 필요, clip_vision · ipadapter 폴더와 파일 이름(받은 뒤 이름 바꾸기), Unified Loader는 이름이 정확해야 함, FaceID는 insightface와 짝 LoRA 필요, weight를 0.8 이하로 낮추고 스텝을 늘리라는 권장, Flux용 모델은 목록에 없음(2026-10-24 main 확인). github.com
- cubiq. ComfyUI_IPAdapter_plus IPAdapterPlus.py — Unified Loader 프리셋 6개, IPAdapter 노드 기본값(weight 1.0 · start_at 0 · end_at 1)과 weight_type 3개가 linear · ease out · style transfer로 바뀌는 줄, IPAdapter Advanced의 weight type 15개, SDXL style transfer = 6번 블록 · composition = 3번 블록, clipvision 크기 224, 정사각형이 아니면 가운데를 자른다는 안내 문구, Prep Image For ClipVision 자르기 자리 6가지(2026-10-24 main 확인). github.com
- cubiq. ComfyUI_IPAdapter_plus utils.py — 프리셋별로 찾는 파일 이름 패턴, VIT-G 프리셋만 bigG 인코더 · 나머지는 ViT-H 인코더(2026-10-24 main 확인). github.com
- cubiq. ComfyUI_IPAdapter_plus 커밋 기록 — 마지막 커밋 2025-04-14 «maintenance mode» · «wording», 그 앞 2025-02-26 병합(2026-10-24 GitHub API 조회). github.com
- cubiq. 예제 워크플로 ipadapter_simple.json — Load Checkpoint → IPAdapter Unified Loader(PLUS) → IPAdapter(weight 0.8 · 0 · 1) → KSampler, Load Image → IPAdapter image, KSampler 30스텝 · cfg 6.5 · dpmpp_2m · karras, 빈 잠재 512×512(2026-10-24 서버 Python으로 JSON 풀어 확인). github.com
- h94. IP-Adapter 모델 저장소(Hugging Face) — 파일별 바이트 수(SD1.5 · SDXL 어댑터, ViT-H 인코더 2,528,373,448바이트 · bigG 인코더 3,689,912,664바이트), 라이선스 apache-2.0 · gated 없음(2026-10-24 05:2x API 조회), safetensors 머리말의 텐서 · 자료형 · 파라미터 수(2026-10-24 서버 Python Range 요청). huggingface.co
- Comfy-Org. ComfyUI comfy/clip_model.py — clip_preprocess 기본 크기 224, crop=True면 짧은 변을 224로 맞춘 뒤 가운데 224×224를 잘라 냄(2026-10-24 master 확인). github.com
- InstantStyle. InstantStyle GitHub 저장소 README — SDXL의 특정 주의 층 둘 가운데 하나는 화풍(색 · 재질 · 분위기), 하나는 공간 배치(구조 · 구도)를 맡는다는 관찰, 화풍 블록에만 넣는 방식(2026-10-24 main 확인). github.com
- Hugging Face. diffusers 문서 IP-Adapter — 기본 모델을 얼리고 작은 그림용 교차 주의 층을 더하는 방식, set_ip_adapter_scale 1.0은 최대 세기 · 0.5가 대개 글과 그림의 균형(2026-10-24 main 확인). github.com