LoRA 학습 사양, SDXL 조건부터 읽기
kohya라는 이름으로 주로 함께 언급되는 저장소는 화면으로 설정하는 kohya_ss와 실제 학습 스크립트를 제공하는 sd-scripts다. GUI는 마우스로 입력하는 설정 화면을 뜻한다. GUI 설치 문서는 하위 저장소까지 받는 복제 방식을 안내한다. 두 저장소의 문서를 읽을 때는 화면 안내와 학습 코드의 안내가 어느 쪽인지 구별해 둔다.
먼저 만들 대상과 기본 모델을 고른다. 체크포인트는 생성 모델 본체를 담은 파일이다. 여기서는 SDXL 기본 모델로 시작한다. SD 계열의 일반 LoRA 안내는 train_network.py를 설명하지만, SDXL용 파일은 sdxl_train_network.py다. 두 저장소 문서는 SDXL LoRA에 --network_train_unet_only 옵션을 강하게 권한다. SDXL에는 텍스트 인코더가 두 개 있어 학습 결과가 예상과 달라질 수 있다는 이유다.
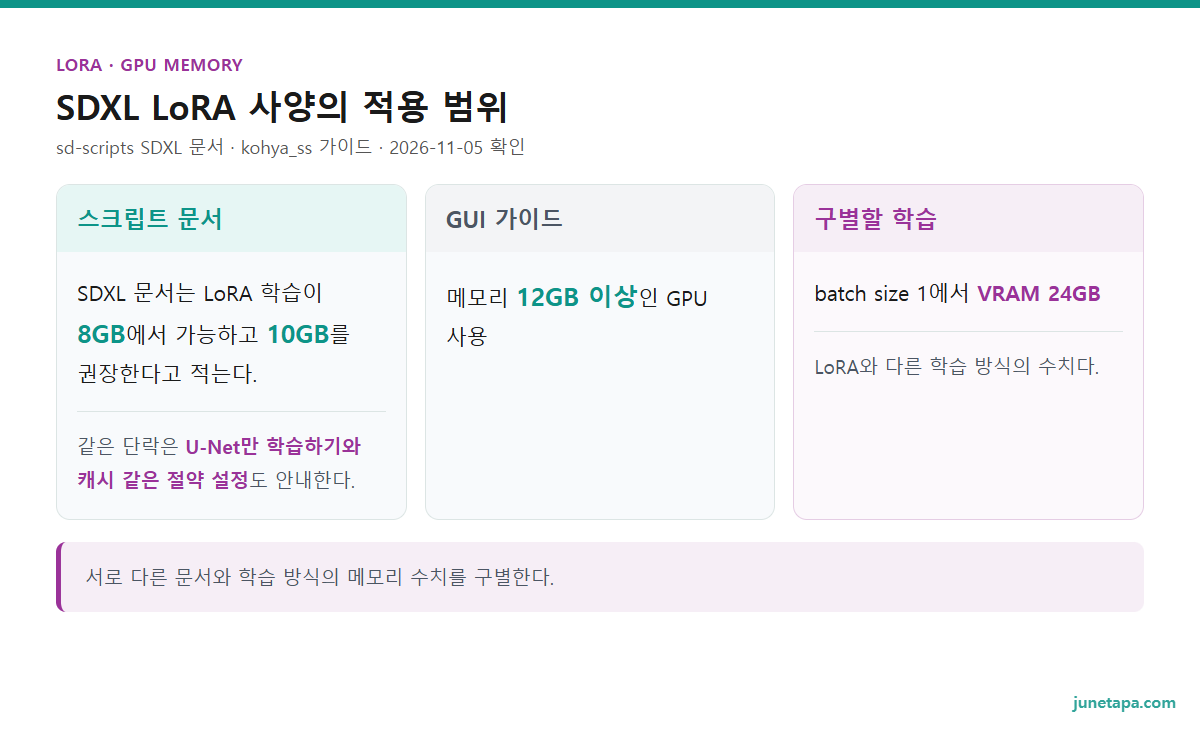
VRAM은 그래픽카드에 달린 전용 메모리다. SDXL 문서는 LoRA 학습이 8GB에서 가능하고 10GB를 권장한다고 적는다. 같은 단락은 U-Net만 학습하기와 캐시 같은 절약 설정도 안내한다. U-Net은 그림의 잡음을 줄여 나가는 본체 부분이다.
| 공식 자료 | 적힌 조건 | 읽어야 할 범위 |
|---|---|---|
| sd-scripts의 SDXL LoRA 안내 | VRAM 8GB 가능, 10GB 권장 | 메모리 절약 옵션과 낮은 rank를 함께 안내한다. |
| 같은 문서의 저용량 설정 | 8GB GPU에는 rank 4~8 제시 | rank는 학습하는 추가 표현의 차원이다. |
| kohya_ss의 SDXL 가이드 | 메모리 12GB 이상인 GPU 사용 | GUI 가이드의 별도 안내이며 앞 수치와 합쳐 새 최저 사양을 만들지 않는다. |
| SDXL 전체 미세 조정 안내 | batch size 1에서 VRAM 24GB | LoRA와 다른 학습 방식의 수치다. |
설치가 끝났는지 확인하는 기준
이 글의 설정 예시는 Windows와 NVIDIA GPU를 전제로 한다. GUI의 Windows pip 문서는 NVIDIA GPU와 CUDA Toolkit 12.8을 준비물로 적는다. CUDA는 NVIDIA GPU를 계산에 쓰는 실행 기반이다. PyTorch는 실제 모델 계산을 맡는 소프트웨어다. GPU가 있다는 사실만으로 두 실행 부품이 맞춰져 있다는 뜻은 아니다.
sd-scripts README는 PyTorch가 환경에 따라 달라 requirements.txt에 포함되지 않는다고 밝힌다. RTX 50 계열에 대해서는 PyTorch 2.8.0과 CUDA 12.8/12.9를 사용하라는 별도 안내도 있다. GPU 용량 비교는 ComfyUI 그래픽카드와 VRAM으로 이어 볼 수 있지만, 생성용 조건을 학습용 조건으로 대신 쓰지는 않는다.
- 설치한 kohya 폴더에서 공식 실행 스크립트로 GUI를 연다. Windows pip 방식의 실행 파일은 아래와 같다.
- 잘 됐으면 브라우저에 GUI가 뜨고 터미널에 시작 오류가 남지 않는다. 화면이 뜨지 않으면 데이터나 학습률을 고치기 전에 설치 문서와 실행 환경을 대조한다.
- LoRA 학습 화면에서 사용할 기본 모델 파일의 실제 위치를 고른다. 잘 됐으면 모델 경로가 입력 칸에 남는다. 파일이 없다는 오류가 나오면 경로와 모델 파일부터 고친다.
.\gui.bat기본 모델 계열, GPU와 VRAM, 설치한 실행 환경을 메모한다. 첫 시도에서는 SDXL과 U-Net만 학습하는 범위로 고정한다. 소스와 설치 사본의 옵션은 다를 수 있으므로 오류가 나면 해당 사본의 도움말도 대조한다.
LoRA 만들기 데이터셋, 이미지와 캡션 짝짓기
데이터셋은 학습에 넣을 이미지와 설명의 묶음이다. 여기서는 설명용 대상인 청록색 머그를 쓴다. 방향·배경·거리가 다른 이미지를 고른다. 특정 장수가 품질을 보증한다는 기준은 두지 않는다.
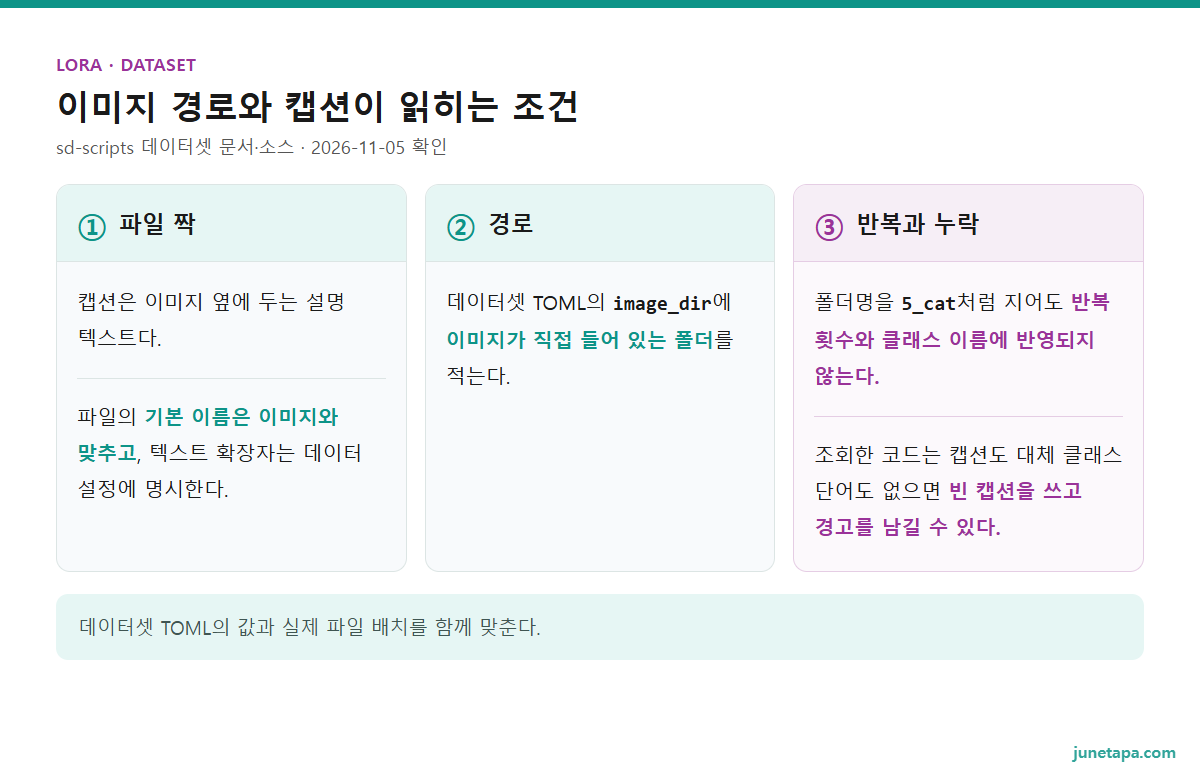
캡션은 이미지 옆에 두는 설명 텍스트다. 파일의 기본 이름은 이미지와 맞추고, 텍스트 확장자는 데이터 설정에 명시한다. 아래는 폴더 예시다. 모델 파일을 실제로 준비하고 모든 경로를 자신의 PC에 맞춘다.
C:/lora-lab/
  images/
    mug-front.png
    mug-front.txt
    mug-side.png
    mug-side.txt
  models/
    sdxl-base.safetensors
  output/
  dataset.toml
train.tomlmug-front.txt에는 아래처럼 그림에서 보이는 내용을 적는다. tealmug는 이 예시에서 대상에 붙인 식별용 단어다. kohya가 그 단어에 특별한 기능을 자동으로 부여하는 것은 아니다.
tealmug, a teal ceramic mug, front view, on a wooden table
폴더 앞 숫자보다 TOML의 반복 값이 우선이다
TOML은 설정 항목과 값을 텍스트로 적는 파일 형식이다. 이 글은 이미지 폴더를 데이터셋 TOML로 지정하는 방식을 쓴다. 공식 문서는 이 방식에서 image_dir 바로 아래에 이미지를 두라고 설명한다. 폴더명을 5_cat처럼 지어도 반복 횟수와 클래스 이름에 반영되지 않는다. 옛 폴더명 규칙만 기억하면 화면의 이미지 수와 예상 학습량이 어긋날 수 있다.
아래 내용을 C:/lora-lab/dataset.toml로 저장한다. 해상도는 SDXL 문서의 1024×1024를 사용하고, batch size(한 번에 처리할 이미지 수)와 반복은 각각 1로 명시한 작성 예시다. 최적 품질을 검증한 조합이 아니라, 폴더와 캡션의 입력 조건을 분명히 만드는 출발점이다.
[general]
caption_extension = ".txt"
shuffle_caption = false

[[datasets]]
resolution = [1024, 1024]
batch_size = 1
enable_bucket = true

[[datasets.subsets]]
image_dir = "C:/lora-lab/images"
num_repeats = 1
bucket은 가로세로 비율에 맞는 해상도 묶음이다. enable_bucket을 켜고 원본의 비율을 다루도록 설정했다. 모든 이미지를 미리 정사각형으로 잘라 중요한 부분을 없애기 전에 이 선택지를 살핀다. 실제 학습에 쓰인 크기는 시작 로그의 해상도와 bucket 정보를 함께 본다.
데이터셋 파일을 주면 train_data_dir 같은 일부 명령행 항목은 무시된다. 해상도·batch size 등 겹치는 설정은 데이터셋 파일 쪽이 우선한다. 폴더 위치를 고쳤는데 그대로라면 모델을 다시 받기 전에 실제로 읽힌 dataset.toml의 image_dir를 본다.
- 이미지와 같은 기본 이름의 캡션을 같은 폴더에 둔다. 잘 됐으면 이미지마다 설명 파일을 찾을 수 있다. Windows에서 확장자를 숨긴 채 만들었다면
.txt.txt가 되지 않았는지 확인한다. - 데이터셋 TOML의
image_dir에 이미지가 직접 들어 있는 폴더를 적는다. 잘 됐으면 학습 시작 로그에 의도한 이미지가 잡힌다. 부모 폴더만 지정했다면 경로를 다시 맞춘다. caption_extension과 실제 설명 파일 확장자를 맞춘다. 캡션을 찾지 못하면 오타와 파일 이름부터 본다. 조회한 코드는 캡션도 대체 클래스 단어도 없으면 빈 캡션을 쓰고 경고를 남길 수 있다. 진행만 된다고 캡션이 읽힌 것은 아니다.
기본 모델과 추가 모델의 관계는 체크포인트와 LoRA 고르기로 이어 볼 수 있다.
인용 — sd-scripts. SDXL trainingThe LoRA training can be done with 8GB GPU memory (10GB recommended).
LoRA 학습은 GPU 메모리 8GB에서 가능하며 10GB를 권장한다는 뜻이다. 같은 단락에 이어지는 메모리 절약 설정까지 함께 읽어야 한다.
kohya LoRA 학습 설정, 캐시와 충돌 없게 맞추기
캐시는 계산한 결과를 보관했다가 다시 쓰는 기능이다. 이미지 잠재값 캐시는 이미지를 모델 내부 표현으로 바꾼 결과를 보관한다. 텍스트 인코더 출력 캐시는 캡션을 모델이 읽을 숫자 표현으로 바꾼 결과를 보관한다. SDXL 문서는 메모리를 줄이는 방법으로 두 캐시를 함께 제시한다.
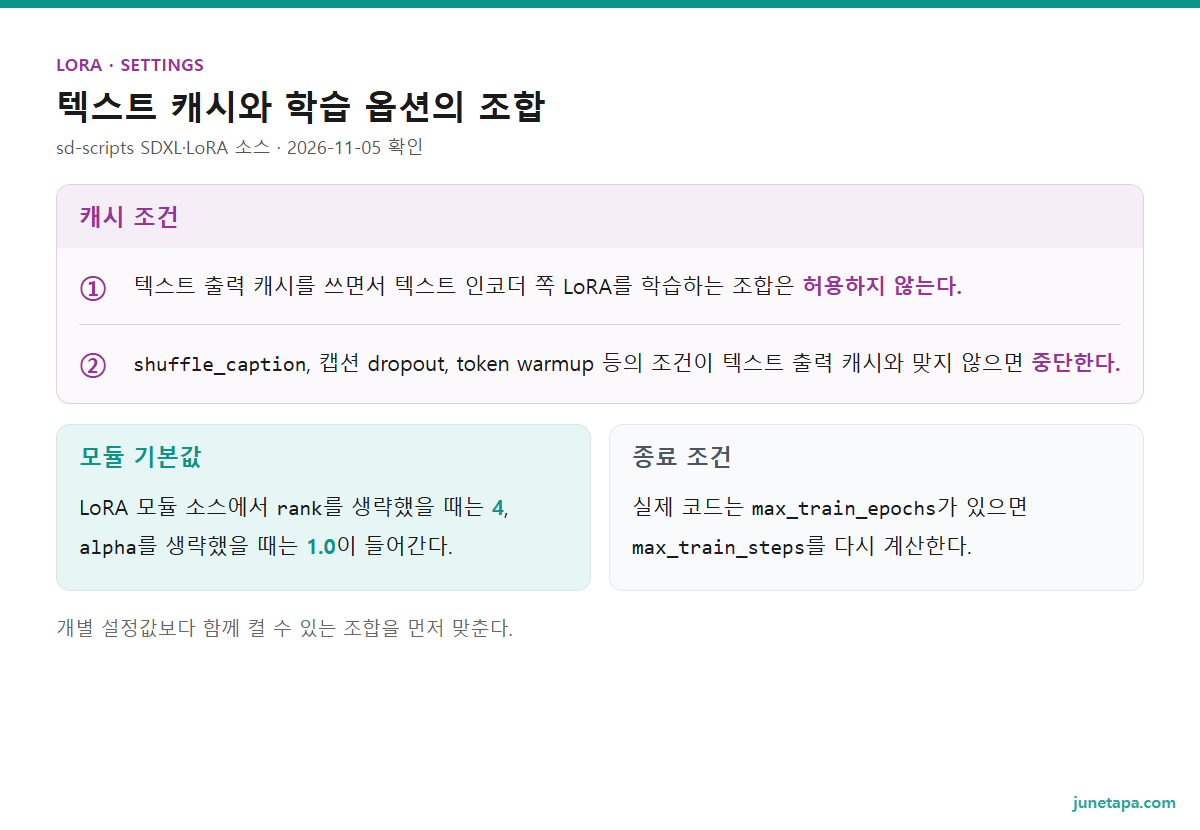
텍스트 결과를 미리 고정해 두면서 매번 캡션 순서나 일부 단어를 바꾸려 하면 입력과 보관한 결과가 맞지 않는다. 실제 SDXL 코드도 이 조합을 시작 단계에서 검사한다. shuffle_caption, 캡션 dropout, token warmup 등의 조건이 텍스트 출력 캐시와 맞지 않으면 중단한다. dropout은 일부 설명을 학습 중 빼는 설정이다.
그리고 텍스트 출력 캐시를 쓰면서 텍스트 인코더 쪽 LoRA를 학습하는 조합은 허용하지 않는다. 그래서 이 예시는 network_train_unet_only를 켜고, 앞의 데이터셋에서는 shuffle_caption = false로 둔다. 메모리 절약 옵션을 켜는 일과 학습할 부분을 정하는 일이 이어지는 지점이다.
C:/lora-lab/train.toml은 데이터셋 파일과 별개다. 아래는 일반 LoRA 예제와 SDXL의 저용량 지침을 조합한 작성 예시다. rank 8은 SDXL 저용량 안내의 범위에서 고른 값이고, alpha 4는 rank 절반을 쓸 수 있다는 설명에 맞춘 값이다. 최적 품질을 보장하는 조합은 아니다.
pretrained_model_name_or_path = "C:/lora-lab/models/sdxl-base.safetensors"
dataset_config = "C:/lora-lab/dataset.toml"
output_dir = "C:/lora-lab/output"
output_name = "tealmug-sdxl"
save_model_as = "safetensors"

network_module = "networks.lora"
network_dim = 8
network_alpha = 4
network_train_unet_only = true

learning_rate = 1e-4
optimizer_type = "AdamW8bit"
lr_scheduler = "constant"
max_train_epochs = 10
save_every_n_epochs = 1

mixed_precision = "fp16"
gradient_checkpointing = true
cache_latents = true
cache_text_encoder_outputs = true
no_half_vae = true
sdpa = true
잘 됐으면 C:/lora-lab 폴더에 dataset.toml과 train.toml 두 파일이 나란히 보인다. 메모장으로 저장했다면 train.toml.txt처럼 확장자가 하나 더 붙지 않았는지 본다. safetensors는 모델 파일을 저장하는 형식 이름이며, save_model_as 값과 기본 모델 파일의 확장자가 같은 이름을 쓴다.
학습률 1e-4, AdamW8bit, constant, 10 epoch과 매 epoch 저장은 일반 LoRA 문서의 실행 예제에서 가져왔다. 학습률은 한 번의 갱신에 얼마나 크게 반영할지 정하는 값이다. epoch은 반복을 포함한 데이터셋을 한 바퀴 도는 단위다. optimizer는 갱신 방법이며, 이 예시의 AdamW8bit에는 bitsandbytes가 필요하다. sd-scripts README는 bitsandbytes가 requirements.txt에 이미 들어 있다고 적는다. 이 optimizer에서 모듈 오류가 나면 따로 설치하기 전에 requirements 설치가 끝까지 됐는지부터 본다.
fp16은 계산에 쓰는 숫자의 정밀도를 줄이는 혼합 정밀도 설정이다. gradient checkpointing은 중간 계산 일부를 다시 수행해 메모리를 아끼며 속도가 줄어들 수 있다. no_half_vae는 이미지 변환 부품인 VAE를 반정밀도로 쓰지 않게 한다. SDXL 문서는 VAE에서 NaN(정상 숫자가 아닌 계산 결과)이 생길 수 있어 이를 피하는 옵션으로 설명한다.
rank와 alpha를 같은 이름으로 읽지 않기
LoRA 모듈 소스에서 rank를 생략했을 때는 4, alpha를 생략했을 때는 1.0이 들어간다. 이 모듈의 기본값이 GUI의 모든 프리셋을 뜻하지는 않는다. 재현할 설정에서는 둘 다 직접 적는 편이 해석하기 쉽다.
같은 코드의 스케일은 alpha / rank다. 학습 중 추가 모델의 반영 계산이며, ComfyUI에서 완성한 LoRA의 적용 강도를 바꾸는 칸과는 구별한다.
학습을 step 수로 끝내고 싶다면 epoch 설정을 남겼는지 먼저 본다. 실제 코드는 max_train_epochs가 있으면 max_train_steps를 다시 계산한다. step은 학습 갱신의 진행 단위다. 종료 조건을 양쪽에 따로 적어 두면 작은 step 값을 넣어도 예상대로 끝나지 않을 수 있다.
첫 비교 뒤에는 캡션 방식이나 rank 가운데 바꿀 항목을 정하고 나머지 설정을 저장해 둔다. 캡션을 섞는 실험을 하려면 텍스트 출력 캐시와의 충돌부터 해소해야 한다.
LoRA 만들기 실행, 저장본과 생성 결과 비교하기
GUI에서는 LoRA 학습 화면에서 기본 모델·데이터셋 설정 파일·출력 폴더를 먼저 맞춘다. SDXL용 학습을 선택하고 앞 예시의 각 항목을 해당 칸에 옮긴다. 데이터셋 TOML 입력 칸과 GUI 설정 저장 파일 입력 칸은 용도가 다를 수 있으므로, dataset.toml을 일반 GUI 프리셋처럼 불러오지는 않는다.
아래 명령은 같은 설정을 스크립트로 실행하는 경로다. 설치가 끝난 sd-scripts 환경을 활성화하고, sdxl_train_network.py가 있는 폴더에서 PowerShell을 연 경우다. GUI로 시작했다면 같은 학습을 터미널에서 중복 실행할 필요는 없다.
accelerate launch .\sdxl_train_network.py --config_file="C:/lora-lab/train.toml"앞의 accelerate launch는 sd-scripts 문서의 학습 예제가 쓰는 실행 방식이다. README의 설치 순서에는 처음 한 번 accelerate config로 실행 설정을 답하는 단계가 있다. config_file은 학습 옵션이 든 train.toml을 읽는다. 그 안의 dataset_config가 이미지와 캡션의 설정 파일을 다시 가리킨다. 파일 이름이 둘 다 TOML이라는 이유로 내용을 한데 섞지 않는다. 잘 됐으면 설정과 이미지 정보를 읽은 뒤 진행을 출력한다.
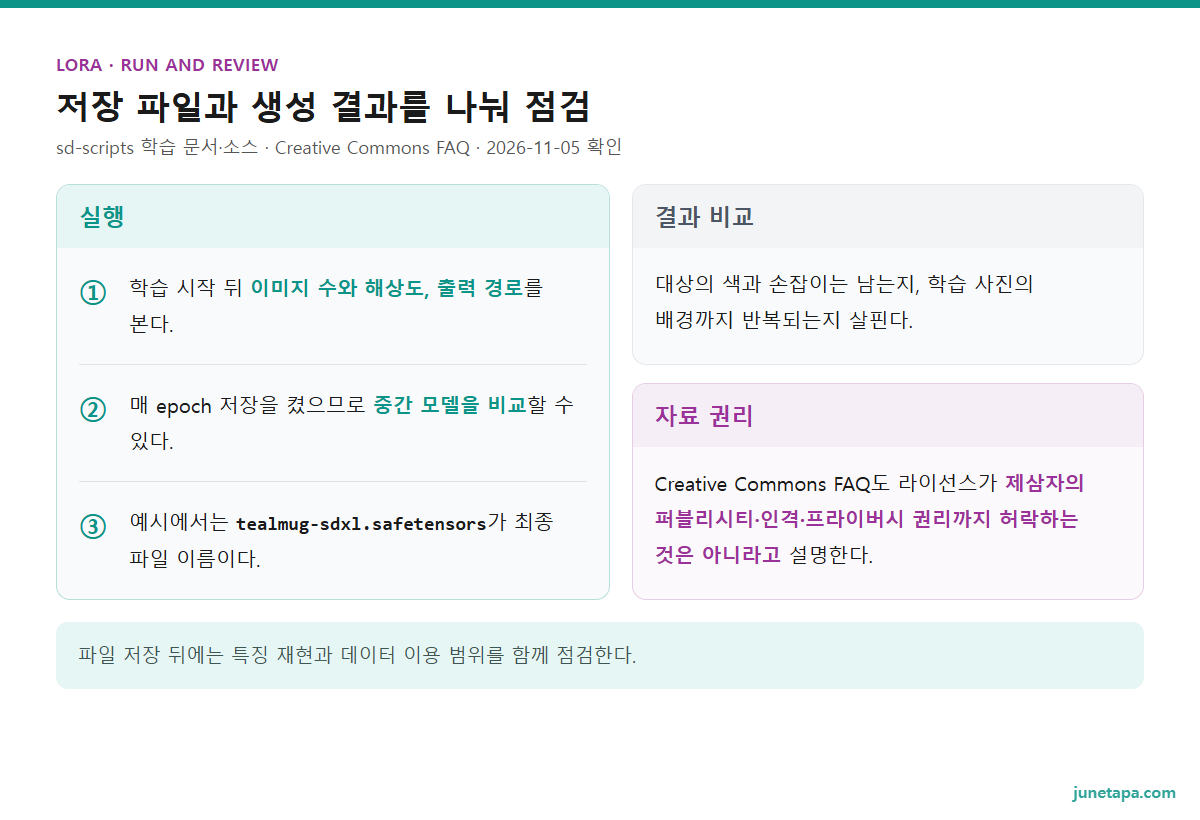
- 학습 시작 뒤 이미지 수와 해상도, 출력 경로를 본다. 의도한 데이터가 읽히지 않으면 진행을 멈추고
dataset.toml의 경로부터 고친다. - 진행이 이어지면 저장 시점에 출력 폴더를 본다. 매 epoch 저장을 켰으므로 중간 모델을 비교할 수 있다.
- 끝났으면
output_dir에output_name과 지정한 형식의 모델이 남았는지 본다. 예시에서는tealmug-sdxl.safetensors가 최종 파일 이름이다.
메모리 부족과 캡션 오류를 나눠 보기
CUDA out of memory는 모델 계산 중 전용 메모리가 부족한 상황이다. 먼저 다른 GPU 작업을 정리하고, batch size가 데이터셋 파일에서 의도대로 적용됐는지 본다. 이 예시의 batch size는 이미 1이므로 더 낮출 여지가 없다. SDXL 문서의 낮은 rank와 캐시 설정을 대조하고, 실제 적용한 조합을 기록한다. 학습률만 낮추는 것으로 메모리 부족 원인을 설명하지는 않는다.
반면 캡션 캐시 관련 assertion(실행 조건이 맞지 않아 멈추는 검사)이 나오면 메모리 용량보다 옵션 조합을 본다. shuffle_caption이나 dropout 설정이 다른 데이터셋·GUI 값에 남아 있는지, U-Net만 학습하도록 했는지 대조한다. 예시 파일을 복사한 뒤에도 GUI의 별도 설정이 섞이면 같은 문제가 남을 수 있다.
NaN이 보이면 정상적인 학습 결과로 평가하지 않는다. 먼저 SDXL 문서가 설명하는 VAE 반정밀도 문제와 no_half_vae 적용 여부를 살핀다. NaN의 원인이 모두 같다는 뜻은 아니다. 이 옵션이 이미 적용됐는데 문제가 남으면 첫 오류와 실행 환경을 함께 남겨 원인을 더 좁힌다.
비교용 프롬프트에는 학습에 없던 장면도 넣는다
저장한 LoRA는 ComfyUI 같은 생성 도구에서 기본 모델과 함께 불러와 비교한다. 실행과 강도 조절은 ComfyUI LoRA 적용과 강도의 순서를 이용한다. 비교할 때는 학습에 쓴 기본 모델 계열을 유지하고, 프롬프트·시드(난수 출발값)·샘플러(생성 계산 절차)·적용 강도를 같은 조건으로 적어 둔다.
머그 예시라면 학습 사진의 탁자와 다른 배경을 요청해 본다. 대상의 색과 손잡이는 남는지, 학습 사진의 배경까지 반복되는지 살핀다. 학습에 쓴 장면과 닮았다는 이유만으로 성공으로 판단하지 않는다. 원하는 특징이 새로운 장면에서도 유지되는지가 이 예시의 평가 기준이다.
실존 인물과 남의 화풍을 재료로 삼을 때
실존 인물을 알아볼 수 있게 학습하는 경우에는 이미지 파일을 구했다는 사실만으로 시작하지 않는다. 사진의 이용 조건과 인물의 초상·개인정보 관련 권리를 따로 검토한다. Creative Commons FAQ도 라이선스가 제삼자의 퍼블리시티·인격·프라이버시 권리까지 허락하는 것은 아니라고 설명한다. 공개된 사진이나 CC 표시만으로 필요한 모든 권리가 해결됐다고 보지 않는다.
남의 화풍을 목표로 삼을 때도 특정 작가의 이미지 묶음을 내려받을 수 있다는 사실과 그 묶음을 학습·배포에 이용할 수 있다는 판단을 분리한다. 화풍이라는 이유만으로 모두 허용되거나 모두 금지된다고 단정하지 않는다. 원본 작품의 조건, 기반 모델의 라이선스, 데이터 공개와 LoRA 배포 범위를 각각 확인해야 할 항목으로 남긴다.
자주 묻는 것
VRAM 8GB면 SDXL LoRA를 만들 수 있나?
sd-scripts 문서는 가능하다고 적지만 메모리 절약 설정을 함께 제시한다. 같은 문서의 권장은 10GB이고, GUI 가이드는 12GB 이상을 안내한다. 자신의 GPU에서 어떤 설정이 끝까지 실행되는지와 완성 품질은 별도로 확인해야 한다.
학습 이미지는 몇 장이 필요한가?
이 글은 모든 대상에 통하는 장수를 제시하지 않는다. 먼저 대상이 드러나는 이미지와 캡션을 준비하고, 실제로 읽힌 이미지 수를 본다. 결과에 배경만 반복되거나 특정 방향에서 특징이 사라지면, 장수를 채우기보다 빠진 구도와 캡션을 검토한다.
캡션 파일이 있는데 왜 설명을 못 찾나?
이미지와 캡션의 기본 이름, 실제 확장자, caption_extension, image_dir를 차례로 본다. 데이터셋 TOML 방식에서는 지정한 폴더 바로 아래에 이미지를 둔다. 조회한 코드는 둘 다 없을 때 빈 캡션으로 계속할 수 있으므로, 경고와 실제 파일 짝을 함께 본다.
steps를 줄였는데 예상보다 오래 도는 이유는?
max_train_epochs가 남아 있으면 코드가 epoch 수에 맞춰 max_train_steps를 다시 계산한다. step으로 제한하려면 epoch 지정도 함께 검토한다. 반복 수와 데이터셋 파일의 적용값을 같이 보아야 예상 학습량을 해석할 수 있다.
여기서 만든 LoRA는 언어 모델에도 붙일 수 있나?
이 글의 실행 파일과 데이터 설정은 이미지 생성 모델용이다. 글을 쓰거나 대화하는 언어 모델의 미세 조정과는 준비 자료와 실행 도구가 다르다. 용어가 같다는 이유로 이미지용 설정을 언어 모델에 옮기지 않는다.
정리 — 모델 계열, 데이터 경로, 설정 조합을 남긴다
kohya로 LoRA를 처음 만들 때는 모델 계열과 메모리 조건을 정한 다음, 이미지와 캡션이 읽히는 폴더를 만든다. 데이터셋 TOML을 쓰면 반복 횟수를 폴더명에 맡기지 않고 파일에 적는다. SDXL에서는 텍스트 출력 캐시와 캡션 변경 기능의 조합도 맞아야 한다.
첫 실행에서 남길 것은 기본 모델 이름, 데이터셋 파일, 학습 설정, 저장본, 같은 조건의 비교 이미지다. 파일이 저장됐다는 사실에서 평가를 끝내지 않고, 새 장면에도 대상의 특징이 남는지 본다. 그 기록이 있어야 다음 학습에서 바꿀 데이터나 설정을 좁힐 수 있다.
참고 자료
- sd-scripts. SDXL training — SDXL VRAM 조건·기본 해상도·캐시 제한(2026-11-05 확인). raw.githubusercontent.com
- kohya_ss. LoRA Resource Guide — GUI 문서의 SDXL 메모리 안내(2026-11-05 확인). raw.githubusercontent.com
- kohya_ss. Windows Installation (pip) — NVIDIA 요구사항·Python 표기 차이·실행 스크립트(2026-11-05 확인). raw.githubusercontent.com
- sd-scripts. README — Windows 실행 환경·PyTorch 분리 설치·RTX 50 안내(2026-11-05 확인). raw.githubusercontent.com
- sd-scripts. Dataset Configuration — 이미지 폴더·반복·캡션·데이터셋 설정 우선순위(2026-11-05 확인). raw.githubusercontent.com
- sd-scripts. library/config_util.py — batch_size·반복 기본값·옵션 이름 대응(2026-11-05 확인). raw.githubusercontent.com
- sd-scripts. LoRA training guide — 학습 옵션·저장 형식·rank와 alpha 설명(2026-11-05 확인). raw.githubusercontent.com
- sd-scripts. networks/lora.py — LoRA 모듈의 기본 rank·alpha·스케일 계산(2026-11-05 확인). raw.githubusercontent.com
- sd-scripts. sdxl_train_network.py — 텍스트 캐시와 캡션 변경·인코더 학습의 충돌(2026-11-05 확인). raw.githubusercontent.com
- sd-scripts. train_network.py — epoch 지정 시 학습 스텝 재계산(2026-11-05 확인). raw.githubusercontent.com
- Creative Commons. FAQ — 저작권 외 제삼자의 권리(2026-11-05 확인). creativecommons.org
- sd-scripts. library/args.py — 학습 TOML을 config_file로 읽는 구현(2026-11-05 확인). raw.githubusercontent.com
- sd-scripts. library/dreambooth_dataset.py — 캡션 파일명 구성·누락 시 빈 캡션과 경고(2026-11-05 확인). raw.githubusercontent.com