Opus 5.5와 GPT-6 Sol, 한 달 동안 어디에 썼나
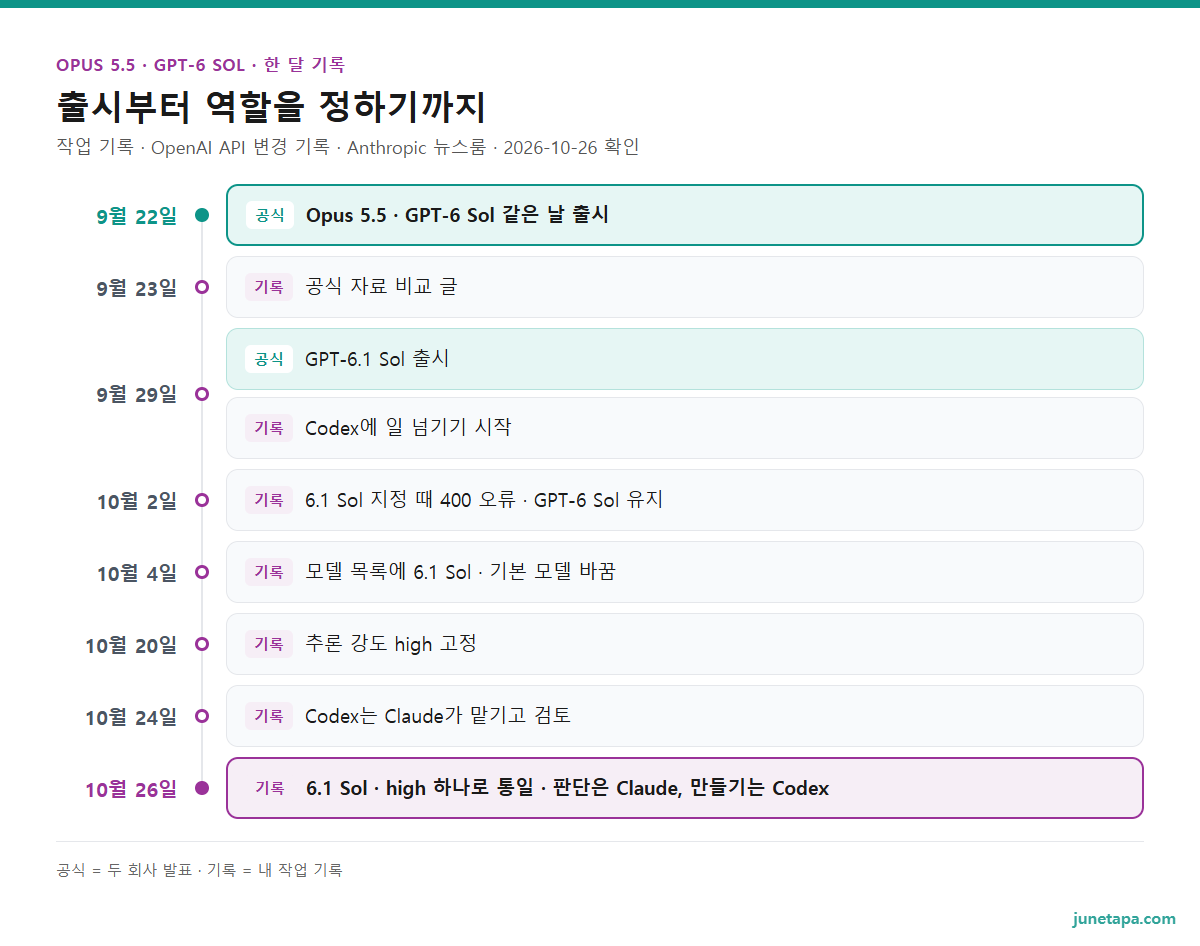
출발점은 비교 글의 결론이었다. 공식 자료만으로는 두 모델을 한 줄로 줄 세울 수 없으니, 직접 나눠 써 보자는 것이다. 9월 말 작업용 윈도 PC에 Codex CLI를 깔고 ChatGPT 계정으로 로그인했다. Claude Code에서는 Opus 5.5를 그대로 썼다. Claude Code를 윈도에 까는 순서와 요금제는 클로드 코드 설치 편에 따로 적었다. Anthropic은 9월 22일 Opus 5.5를 내면서 «에이전트 코딩과 지식 업무에서 앞서고, 일반적인 작업량에서 Opus 5보다 40% 덜 든다»고 소개했다. 10월 26일 Anthropic 모델 문서의 현재 모델 표에서도 가장 새 Opus는 claude-opus-5-5이고, 뉴스룸에도 그 뒤 새 Opus 발표는 없다.
OpenAI 쪽은 한 달 사이 이름이 바뀌었다. OpenAI API 변경 기록을 보면 GPT-6 Sol은 9월 22일, GPT-6.1 Sol은 9월 29일에 나왔고, 6.1 Sol의 표준 요금은 100만 토큰당 입력 $2, 캐시 입력 $0.10, 출력 $10이다. 그런데 10월 2일 내 Codex에서 6.1 Sol을 기본 모델로 지정하자 요청이 400 오류로 돌아왔다. 그래서 GPT-6 Sol로 되돌렸고, 10월 4일 Codex의 모델 목록에 6.1 Sol이 보인 뒤에야 기본 모델을 바꿨다. 출시일과 내 계정에서 실제로 쓸 수 있게 된 날 사이에 며칠 틈이 있었던 셈이다. Codex 공식 문서도 6.1 Sol은 따로 출시 범위가 있고, 계정과 로그인 방식, 쓰는 앱에 따라 열리는 시점이 다르다고 적었다.
처음엔 «Claude만 쓰지 말자»에서 시작했다
Codex를 붙인 이유는 성능 비교보다 사용량이었다. Claude 쪽은 Max 요금제를 쓰는데도 한 주 한도가 먼저 신경 쓰였고, ChatGPT 구독은 Codex를 거의 쓰지 않은 채 놀고 있었다. 그래서 9월 29일에 정한 첫 규칙은 «Claude에만 기대지 말고 Codex에 던져 준 뒤, 결과를 Claude가 다시 분석하고 정리한다»였다.
그 뒤로 규칙은 몇 번 바뀌었다. 10월 4일에는 일반 그림은 6.1 Sol, 복잡한 영상과 복잡한 개발은 GPT-6 Astra로 나눴다. 10월 20일에는 Codex를 쓸 때 추론 강도를 high로 고정했다. 10월 26일에는 모델을 6.1 Sol · high 하나로 통일하고, 같은 일을 6.1 Sol이 두 번 실패했을 때만 그 일에 한해 Astra를 한 번 쓰기로 했다. 모델을 여럿 섞으면 결과가 어느 모델에서 나왔는지부터 따져야 해서, 하나로 묶는 편이 확인이 쉬웠다.
판단은 Claude, 만들기는 Codex — 실사용에서 갈린 역할
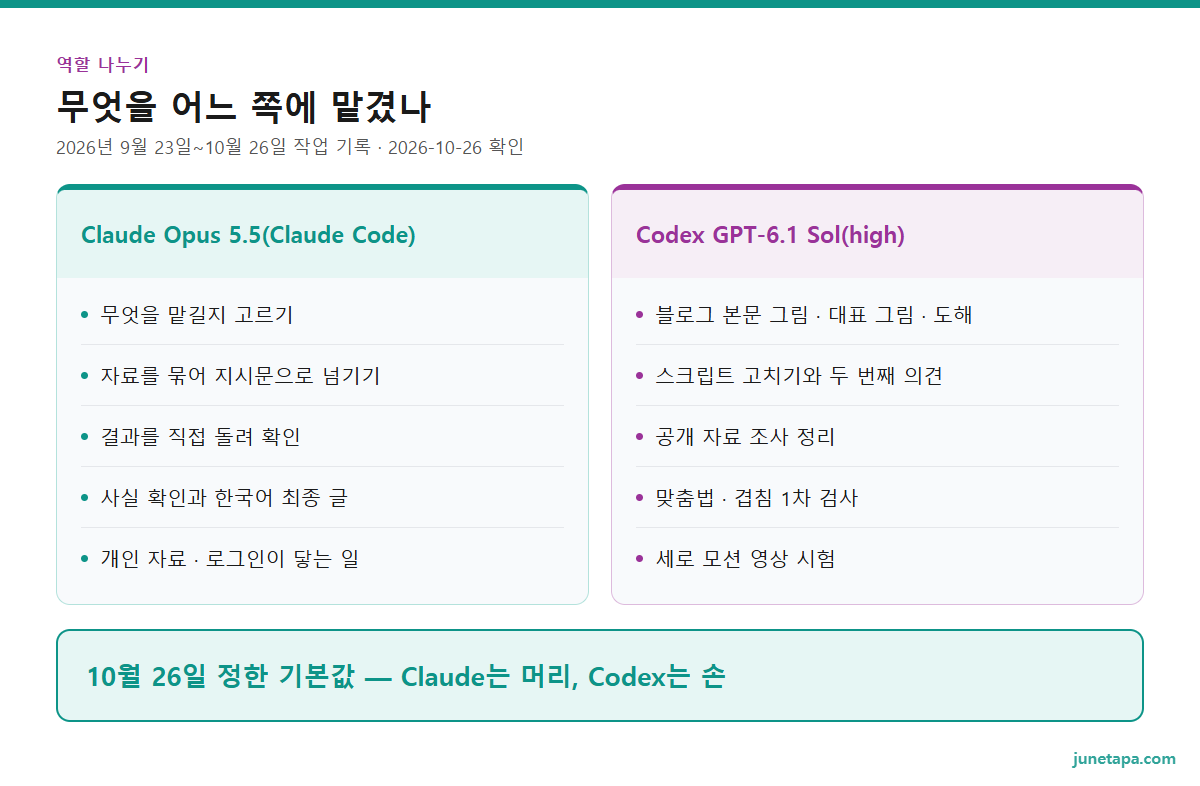
10월 24일까지는 내가 Codex 창을 직접 열어 일을 시키기도 했다. 그런데 직접 쓰면 일이 하나하나 막혔다. 정리해 보니 이유는 셋이었다. Codex 샌드박스가 네트워크 드라이브에 있는 작업 폴더에서 셸 명령을 시작하지 못해 자료를 PC 안 폴더로 옮겨야 했고, Codex는 내가 정해 둔 작업 규칙과 이전 기록을 모르며, 명령마다 승인 창이 자주 떴다. 그래서 10월 24일부터는 Claude가 Codex 플러그인으로 일을 맡기는 쪽으로 바꿨다. Claude가 자료를 로컬 폴더에 묶고 규칙을 지시문에 넣어 넘기면 Codex가 만들고, 결과는 Claude가 직접 돌려 보고 반영한다.
10월 26일에 정한 기본값은 이렇다. 코딩과 스크립트 고치기, 그림 · 영상 만들기, 버그 원인 찾기, 맞춤법 · 링크 · 겹침 같은 기계적인 1차 검사는 Codex가 먼저 한다. Claude는 무엇을 맡길지 고르고, 결과를 실행해 확인하고, 마지막 판단과 최종 글을 맡는다. 한 줄로 줄이면 «Claude는 머리, Codex는 손»이다. Codex 공식 문서도 복잡한 코딩과 에이전트 작업에는 GPT-6.1 Sol을, 범위가 좁고 반복되는 일에는 Luna를 권한다. 내 쪽은 반복 작업까지 6.1 Sol 하나로 몰았다는 점만 다르다.
Codex에 넘긴 일, Claude에 남긴 일
실제로 넘긴 일은 이렇다. 블로그 글에 들어가는 본문 그림과 대표 그림은 10월 21일부터 Codex(6.1 Sol · high)가 만든다. 그림 넣는 구조를 바꾼 첫 글을 보고 «퀄리티가 확실히 좋아졌다»고 느껴 그대로 굳혔다. 10월 26일부터는 이 글에 들어간 것 같은 도해도 Codex가 HTML로 그린다. 그 밖에 내가 고친 스크립트의 두 번째 의견, 공개 자료 조사 정리, 블로그 원고의 1차 맞춤법 · 겹침 검사, 로컬 문서 검색 스크립트의 버그 원인 찾기, 세로 모션 영상 시험을 Codex에 맡겼다.
그림이 늘 한 번에 나온 것은 아니다. 10월 7일 블로그 그림 9장을 만들 때는 1장에 서명 같은 낙서가 들어가 두 번 다시 그렸다. 지시문에 «글자 · 숫자 · 사람 · 로고 없음»을 넣어도 생기는 일이라, 그림은 다섯 장을 한 장에 모은 확인용 사진으로 Claude가 한 번 더 본다.
6.1 Sol로 바꾸기 전 GPT-6 Sol에 맡긴 일도 있다. 9월 29일에는 작업 현황 페이지를 만드는 빌드 스크립트에서 경로 설정을 따로 빼는 일을 GPT-6 Sol(high)에 맡겼다. 13.6분 걸렸고, Claude가 조정을 한 번 이어서 시킨 뒤 실제 경로로 빌드가 통과했다. 10월 5일에는 블로그 글 점검 항목 다섯 개를 검사 스크립트로 만드는 일을 GPT-6 Sol(medium)에 맡겼다. 4.3분 만에 나왔고, Claude가 잘못 걸리는 경우 1개를 고친 뒤 단위 시험 10개가 통과했다. 이때부터 «Codex가 만든 것은 Claude가 실제로 돌려 본 뒤 반영한다»가 굳었다.
Claude에 남긴 일은 판단이 걸린 것들이다. 무엇을 맡길지 고르기, 지시문 쓰기, Codex가 낸 지적이 진짜인지 코드로 하나씩 확인하기, 사실 확인과 한국어 최종 글이다. 개인 자료나 계정 로그인이 닿는 일은 Codex에 넘기지 않았다. Codex에 넘긴 자료는 OpenAI 쪽으로 가기 때문에, 넘기기 전에 개인정보 검사기를 먼저 돌리는 단계도 Claude 몫으로 뒀다. 10월 24일에는 링크를 읽고 판정 노트를 쓰는 일까지 Codex로 옮길지 따져 봤지만, 한국어 노트와 과장 여부 판정은 Claude 쪽이 매끄러워 그대로 두었다. 대신 링크가 깃허브의 도구 코드일 때만, 그 코드에 위험한 부분이 없는지 Codex에 읽기 전용으로 두 번째 의견을 묻는다.
인용 — OpenAI. Codex — Agent approvals & security«Locally, Codex uses an OS-enforced sandbox that limits what it can touch (typically to the current workspace), plus an approval policy that controls when it must stop and ask you before acting.» — 로컬에서 Codex는 운영체제가 강제하는 샌드박스로 손댈 수 있는 범위를 (보통 지금 작업 폴더로) 제한하고, 행동하기 전에 언제 멈춰서 사용자에게 물어야 하는지를 정하는 승인 정책을 함께 쓴다.
Codex를 직접 쓸 때 막힌 자리 대부분이 이 한 문장에서 나왔다. 같은 문서는 기본으로 네트워크 접속도 꺼 둔다고 적었다.
Codex(GPT-6.1 Sol)에서 막힌 곳과 돌아간 길
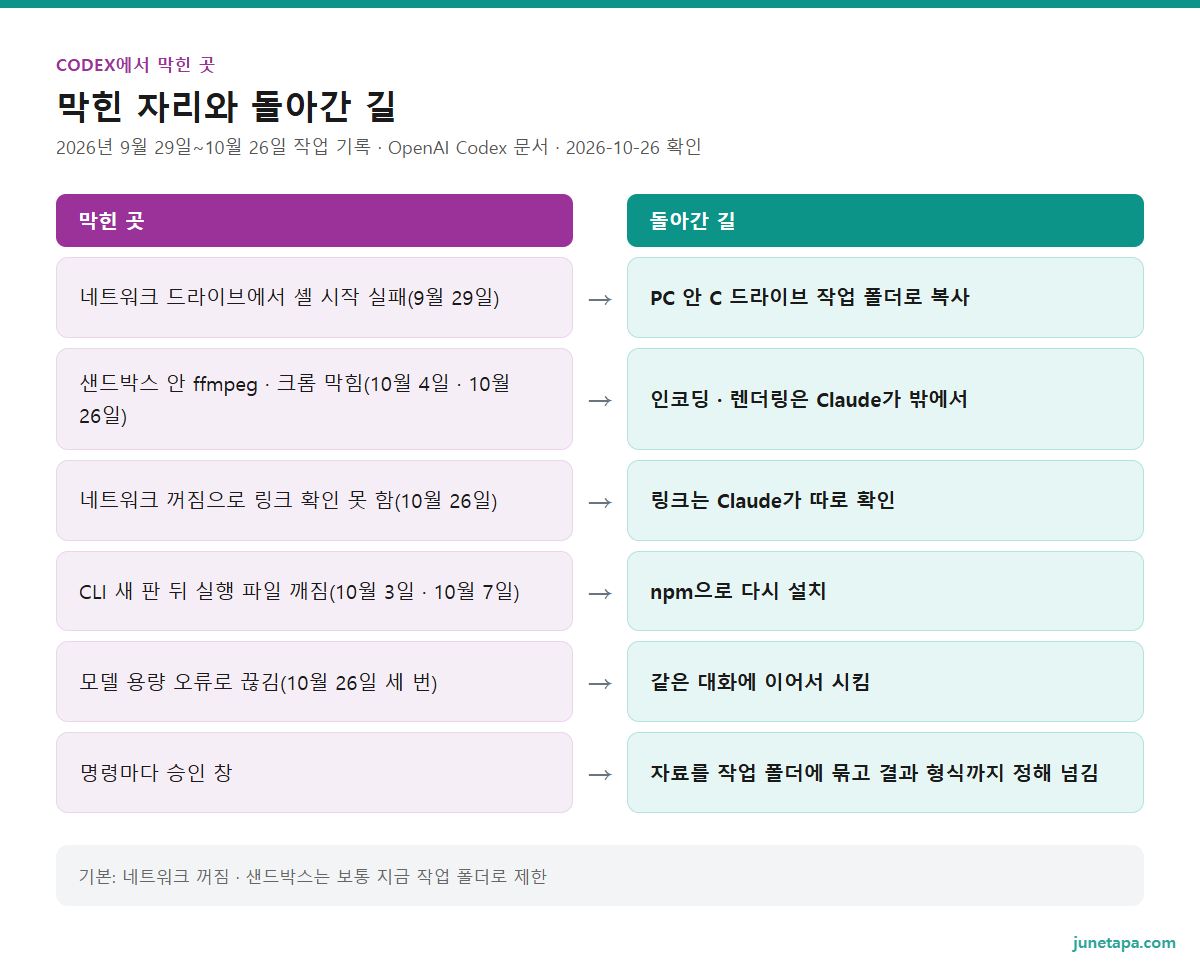
샌드박스와 승인 정책은 안전장치다. 다만 내 작업 방식과는 몇 군데서 부딪혔다. 기록에 남은 것을 순서대로 적는다.
첫째, 작업 폴더 위치다. 9월 29일 시험에서 Codex 샌드박스는 네트워크 드라이브 경로와 공유 폴더 경로 모두에서 셸을 시작하지 못했다. 그래서 PC 안 C 드라이브에 같은 모양의 작업 폴더를 두고, 결과를 네트워크 드라이브와 맞추는 방식으로 바꿨다. 한글이 들어간 경로도 피해서, 그림은 영문 이름의 임시 폴더에서 만든 뒤 옮겼다.
둘째, 샌드박스 안에서 못 하는 일이다. 영상 도구를 만들게 한 10월 4일과 모션 영상을 시험한 10월 26일에는 샌드박스가 ffmpeg 접근을 막아, 영상 인코딩을 Claude가 밖에서 했다. 디자인 틀을 만들게 한 10월 26일에는 샌드박스 안 크롬이 막혀 렌더링 확인을 Claude가 밖에서 했고, 같은 날 원고 1차 검사에서는 네트워크가 막혀 링크가 열리는지를 Claude가 따로 확인했다. 공식 문서가 말한 «기본 네트워크 꺼짐, 작업 폴더 제한»과 그대로 맞는 장면들이다.
끊기면 같은 대화에 이어서 시킨다
셋째, 도구 쪽 문제다. Codex CLI가 새 판으로 올라간 직후 실행 파일이 깨져(EFTYPE 오류) npm으로 다시 깐 일이 10월 3일과 10월 7일 두 번 있었다. 넷째, 모델 쪽 끊김이다. 10월 26일 하루에만 «모델 용량» 오류로 작업이 중간에 끊긴 일이 세 번 있었다. 세 번 모두 같은 대화(스레드)에 이어서 시키니 끝까지 갔고, 그중 한 번은 끊기기 전에 결과 파일이 이미 완성돼 있었다. 처음부터 다시 시키면 앞서 한 일을 또 하게 되니, 이어서 시키는 쪽이 사용량도 덜 든다.
다섯째가 가장 자주 부딪힌 승인 창이다. 명령마다 확인을 묻는 것은 문서대로의 동작이고, 확인을 통째로 건너뛰게 하는 것은 답이 아니라고 봤다. 대신 Claude가 필요한 자료를 작업 폴더 하나에 미리 다 넣고, 결과 파일 이름과 «맨 위에 요약 20~40줄» 같은 결과 형식까지 지시문에 정해 넘겼다. Codex가 폴더 밖으로 나갈 일이 줄면 묻는 일도 줄었다. Claude Code용 Codex 플러그인을 쓸 때도 비슷한 요령이 필요했다. 플러그인의 review 명령은 git 변경분을 보는데 내 작업 폴더는 git 저장소가 아니어서, 고치기 전 사본을 같이 넘기고 «이 사본과 비교해 검토하라»는 task 명령으로 대신했다. task는 읽기 전용이 기본이고, 파일을 고치게 할 때만 쓰기를 허용해 넘긴다. 에이전트가 어디서 멈추고 사람에게 묻는 것이 맞는지는 브라우저 에이전트가 멈춰야 할 곳 편에 따로 정리했다.
실사용 기록에 남은 시간과 사용량
아래 숫자는 모두 내 작업 기록에 남은 값이고, 잰 날짜를 함께 적는다. 같은 일을 Claude에 시킨 값과 나란히 잰 것은 아니어서 «어느 쪽이 빠르다»는 비교로 읽으면 안 된다.
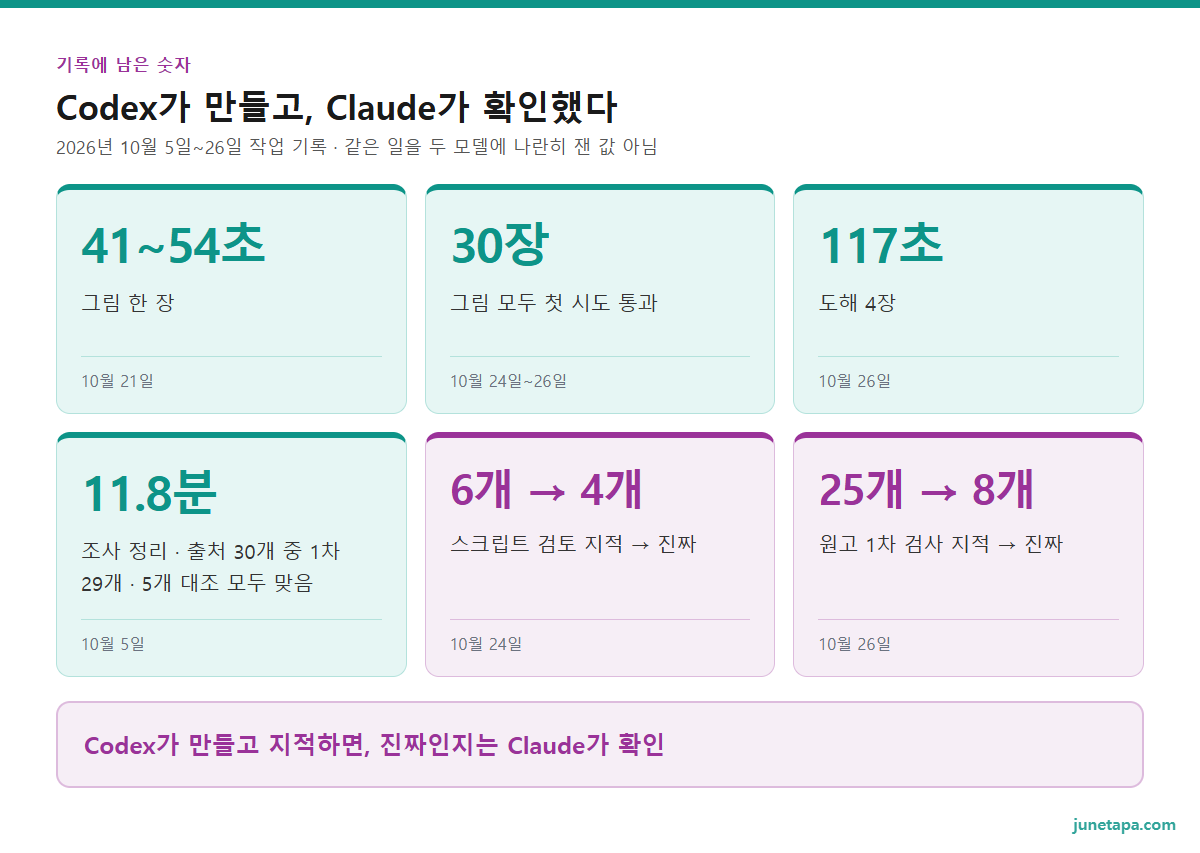
- 블로그 본문 그림: 한 장에 41~54초(10월 21일). 10월 24일부터 26일까지 글 여섯 편에 들어간 그림 30장은 모두 첫 시도에 통과했다.
- 도해 4장: Codex가 HTML을 쓰는 데 112초, 글자 대조와 캡처까지 117초(10월 26일 시험). 4장 모두 잘림 · 넘침 없이 첫 시도에 통과했다. 이 글의 도해 4장도 같은 방식으로 만들었는데, Codex 144초에 캡처까지 150초가 걸렸다(10월 26일 밤).
- 공개 자료 조사 정리: 11.8분, 출처 30개 중 1차 출처 29개(10월 5일). Claude가 그중 5개를 원문과 직접 대조했고 모두 맞았다.
- 스크립트 두 번째 의견: 2분 35초, 지적 6개 중 코드로 확인한 진짜는 4개(10월 24일).
- 원고 열네 개 1차 검사: 약 10분, 지적 25개 중 진짜 8개(10월 26일). 걸러진 17개 중 14개는 일부러 반복해 넣은 고정 문구였다.
- 출력 줄이기 스크립트: 실행 출력 33줄이 4줄로(10월 26일). Claude 검토에서 따옴표 묶음이 깨지는 문제 1개를 찾아, 같은 대화에 이어서 고치게 했다.
- 세로 모션 영상 시험 세 가지: 같은 대화에서 세 번에 걸쳐 약 40분(22분 · 14분 · 3분, 10월 26일). Claude가 짚은 고칠 점 7개를 고쳤고, 그중 한 영상의 렌더링 시간은 240.7초에서 88.6초로 줄었다.
사용량 — Claude는 아껴 쓰고, Codex는 남기지 않는다
사용량 쪽 체감은 두 회사가 정한 한도 구조와 맞물려 있었다. Anthropic 도움말에 따르면 Pro와 Max 요금제에는 5시간 세션 한도와 주간 한도가 있고, 이 한도는 Claude 앱과 Claude Code가 함께 쓴다. 그래서 Claude 쪽은 무거운 작업을 한 주 한도가 다시 채워지기 직전에 몰아서 하는 식으로 아껴 썼다. Claude가 읽는 양을 줄이는 장치도 하나 더 뒀다. Codex 결과는 맨 위에 20~40줄 요약을 먼저 쓰고 자세한 내용은 따로 파일로 남기게 해서, Claude는 요약과 지적된 줄만 읽는다. 전체 파일은 필요할 때 내가 직접 연다.
Codex 쪽은 반대였다. 10월 26일에 내린 결론은 «GPT는 사용량이 자주 다시 채워지니, 맡길 수 있는 건 최대한 맡긴다»였고, 같은 날 «무거운 작업은 모두 Codex로, 품질을 위해 두세 번 다듬어도 된다»로 넓혔다. 공식 문서를 보면 이유가 보인다. Codex 요금 안내는 Plus 요금제의 5시간당 메시지 수를 GPT-6.1 Sol 기준 15~160개로 추정하면서, Pro 요금제에는 현재 5시간 한도가 없고 주간 한도는 걸릴 수 있다고 적었다. 10월 26일 내 Codex 사용량 기록에도 주간 창 하나만 있고 5시간 창은 없었다. 다만 같은 안내는 이미지 생성이 포함 한도를 평균 3~5배 빨리 쓴다고 적었으니, 그림을 많이 만드는 날은 주간 한도를 따로 봐야 한다. Claude 쪽 한도가 닳는 방식은 클로드 사용 한도 편에 자세히 적었다.
같은 일을 둘에 시킨 비교는 아직이다
위 숫자들은 «Codex에 맡기니 이만큼 걸렸고, Claude가 걸러 보니 이만큼이 진짜였다»는 기록이다. 같은 지시를 Opus 5.5와 6.1 Sol에 동시에 주고 결과를 채점한 실험은 이 기간에 하지 않았다. 지적 가운데 적지 않은 수가 걸러졌다는 숫자도, Codex가 틀렸다기보다는 내 작업 규칙을 모르는 상태에서 낸 1차 의견을 규칙을 아는 쪽이 거른 결과로 읽는 편이 맞다. 걸러진 것 대부분이 일부러 넣은 고정 문구나 원래 이름을 그대로 쓴 자리였다는 점이 그 근거다.
자주 묻는 것
Opus 5.5와 GPT-6.1 Sol 중 코딩에는 어느 쪽을 쓰나요?
이 기간 제 결론은 «둘 다, 역할을 나눠서»였습니다. 코드를 쓰고 고치는 손은 Codex의 GPT-6.1 Sol에 맡기고, 무엇을 고칠지 정하고 결과를 돌려 확인하는 일은 Claude Code의 Opus 5.5가 맡았습니다. 같은 과제로 둘을 나란히 채점하지는 않았으니, 고르기 전에 실제로 맡길 과제 몇 개를 양쪽에 돌려 보는 편이 확실합니다.
Codex가 네트워크 드라이브 폴더에서 명령을 못 돌립니다.
9월 29일 제 PC에서도 Codex 샌드박스는 네트워크 드라이브와 공유 폴더 경로에서 셸을 시작하지 못했습니다. OpenAI 문서는 로컬 Codex가 운영체제 샌드박스로 손댈 수 있는 범위를 보통 지금 작업 폴더로 제한한다고 설명합니다. PC 안 로컬 폴더에 작업 사본을 두고 결과만 옮기는 방식으로 풀었습니다.
Codex에서 GPT-6 Sol과 GPT-6.1 Sol 중 무엇을 고르나요?
Codex 문서는 복잡한 코딩과 에이전트 작업에 GPT-6.1 Sol을 권하고, 6.1 Sol을 Astra에 가까운 성능을 더 낮은 비용으로 내는 모델로 소개합니다. 출시 직후에는 계정에 따라 바로 열리지 않을 수 있으니 모델 목록에 보이는지 먼저 확인합니다. 제 경우 9월 29일 출시 뒤 10월 4일에 목록에서 보였습니다.
ChatGPT 일반 채팅에서도 GPT-6.1 Sol을 쓸 수 있나요?
Codex 문서 기준으로 GPT-6.1 Sol, GPT-6 Sol, GPT-6 Luna는 ChatGPT의 Work와 Codex에서 쓸 수 있고 일반 Chat에는 없습니다. 6.1 Sol의 출시 범위는 Plus, Pro, Business, Enterprise, Edu이고, 무료와 Go는 출시 때 빠졌습니다.
Codex 사용량은 언제 다시 채워지나요?
요금제마다 다릅니다. Codex 요금 안내는 Plus의 5시간당 메시지 수를 추정치로 보여 주고, Pro에는 현재 5시간 한도가 없으며 주간 한도는 걸릴 수 있다고 적었습니다. 정확한 남은 양과 다시 채워지는 시각은 사용량 화면에서 보라고 안내합니다.
정리 — Opus 5.5 · GPT-6 Sol 한 달 써 보고 정한 세 가지
9월 23일 비교 글에서는 공식 자료만으로 두 모델을 줄 세울 수 없다고 적었다. 한 달을 실제로 나눠 써 본 지금도 «어느 쪽이 더 똑똑한가»에는 답하지 않는다. 대신 내 작업에서 정한 것은 세 가지다.
첫째, 역할을 나눈다. 판단 · 확인 · 최종 글은 Claude Opus 5.5, 그림 · 도해 · 스크립트 · 1차 검사는 Codex의 GPT-6.1 Sol(high)이다. 둘째, Codex에는 묶인 일만 넘긴다. 샌드박스가 작업 폴더 밖과 네트워크를 막는 것이 기본이니, 자료와 결과 형식을 폴더 하나에 담아 넘기면 덜 막힌다. 셋째, 사용량 구조에 맞춰 쓴다. Claude는 5시간 · 주간 한도를 Claude 앱과 함께 쓰니 아껴 쓰고, Codex에는 맡길 수 있는 무거운 일을 몰아준다. Codex가 낸 결과와 지적은 그대로 쓰지 않고 Claude가 한 번 더 확인한다는 원칙은 이 기간 내내 바뀌지 않았다.
참고 자료
- Anthropic. Newsroom — Introducing Claude Opus 5.5 — 2026-09-22 발표, «Claude Opus 5.5 leads in agentic coding and knowledge work, and costs 40% less to run than Opus 5 on typical workloads», 뉴스룸에 Opus 5.5 뒤 새 Opus 발표 없음(2026-10-26 확인). anthropic.com
- Anthropic. Models overview — 현재 모델 표 claude-opus-5-5 · claude-sonnet-5-5 · claude-fable-5-1(2026-10-26 확인). platform.claude.com
- OpenAI. API Changelog — 2026-09-22 GPT-6 Sol · Luna 출시, 2026-09-29 GPT-6.1 Sol 출시와 표준 요금(100만 토큰당 입력 $2 · 캐시 입력 $0.10 · 출력 $10), 10월 22일 항목까지 새 Sol 모델 없음(2026-10-26 확인). developers.openai.com
- OpenAI. Codex — Models — 복잡한 코딩 · 에이전트 작업엔 GPT-6.1 Sol, 범위가 좁고 반복되는 일엔 Luna 권장, 6.1 Sol = Astra에 가까운 성능을 더 낮은 비용으로, ChatGPT에서는 Work · Codex에만(Chat 없음), 6.1 Sol 출시 범위 Plus · Pro · Business · Enterprise · Edu, 계정 · 로그인 방식 · 앱에 따라 열리는 시점이 다름(2026-10-26 확인). developers.openai.com
- OpenAI. Codex — Agent approvals & security — 기본 네트워크 꺼짐, 로컬은 OS 샌드박스가 보통 지금 작업 폴더로 제한, 행동 전에 묻는 승인 정책(2026-10-26 확인). developers.openai.com
- OpenAI. Codex — Pricing — Plus 5시간당 로컬 메시지 추정(GPT-6.1 Sol 15~160), Pro는 현재 5시간 한도 없음, 주간 한도는 걸릴 수 있음, 이미지 생성은 포함 한도를 평균 3~5배 빨리 씀, 남은 양 · 다시 채워지는 시각은 사용량 화면(2026-10-26 확인). developers.openai.com
- Anthropic. Using Claude Code with your Pro or Max plan — Pro · Max 요금제의 5시간 세션 한도와 주간 한도, Claude와 Claude Code가 같은 한도를 함께 씀(2026-10-26 확인). support.claude.com